第 14 期 · 2026-W43 2026年10月18日 — 10月25日
✦ 本周速览

本周聚焦AI与科技前沿,亚马逊CEO深度访谈揭示算力需求之巨,不容错过的头条《Claude Prompt Caching Hit 0 of 1,412 Calls: A Timestamp Killed It》带你探秘技术细节。此外,还有揭秘B2B SaaS陷阱、内存巨头美光崛起背后的故事,尽在本期精彩内容中。

Claude Prompt Caching Hit 0 of 1,412 Calls: A Timestamp Killed It 配图
头 条

Claude Prompt Caching Hit 0 of 1,412 Calls: A Timestamp Killed It

核心内容
文章主要讲述了一个名为Claude的API在使用prompt caching时出现的问题,即由于请求前缀的微小差异导致缓存命中率极低,通过修复这些问题后,缓存命中率显著提高。
为什么重要
这个内容值得关注,因为它揭示了在实际应用中可能遇到的缓存问题,并展示了如何通过细致的分析和修复来优化性能。这反映了在软件开发中对于细节的关注和调试的重要性。
关键洞察
最有价值的观点是,即使是微小的差异,如请求前缀的一个字符不同,也会导致缓存命中率从100%下降到0%。此外,文章强调了日志记录在问题诊断中的重要性,指出如果不记录缓存读取输入令牌,可能永远无法发现这种问题。
潜在影响
谁会受影响的是使用类似技术或系统开发者和维护者。这种问题的存在可能导致资源浪费和性能下降。通过修复这些问题,可能会产生资源使用效率的提升和系统性能的改进。

I turned on Claude prompt caching, shipped it, and moved on to the next thing. A week later I opened the usage logs to admire my savings.

cache_read_input_tokens: 0. On every call. 1,412 calls in a row.

展开全文收起全文剩余 54 段 · 约 23 分钟

The API never returned an error. My cache_control blocks looked fine. Every request quietly paid full price for the same 6,000-token prefix, over and over, and the response told me so in a field I wasn't reading. This is the autopsy: three separate bugs, each enough to kill the cache by itself, and the logging that would have caught them on day one.

TL;DR

Claude prompt caching only hits when the request prefix (tools, then system, then messages) is byte-identical up to the cache breakpoint. One changed character before the breakpoint means a full miss.

My system prompt started with Current time: 09:41:07. That alone gave me a 0% hit rate.

My tool list was built from a Python set. String hashing is randomized per process, so each of my 4 workers sent the tools in a different order. Hit rate stopped at 66%.

One prompt variant was too short to cache at all. No error, no warning, just cache_creation_input_tokens: 0.

After fixing all three: 94% of calls hit the cache and input token cost per session fell 58%. Log cache_read_input_tokens on every call or you will never know.

What was I caching?

The system in question is Preterview, a voice interview practice tool I built and run (full disclosure: I built it, it's at preterview.com). Each session is a back-and-forth with an AI interviewer in one of three styles, and every turn sends the same big chunk of context: interviewer persona, scoring rubric, and the candidate's parsed resume.

That chunk is about 6,000 tokens and it doesn't change during a session. A session averages 12 to 14 turns. Re-sending 6,000 identical tokens 14 times is the textbook case for prompt caching, which is why I added it in about ten minutes and assumed it worked.

Here's roughly what the call looked like:

``` resp = client.messages.create( model=MODEL, max_tokens=600, tools=build_tools(session), system=[ { "type": "text", "text": build_system_prompt(session), "cache_control": {"type": "ephemeral"}, } ], messages=session.history, ) ```

Looks right. It was not right.

How does Claude prompt caching decide what's a hit?

Claude prompt caching matches on an exact prefix. The request is treated as one ordered sequence: tool definitions first, then the system prompt, then messages. A cache_control breakpoint says "cache everything up to here." On the next call, if every token up to that breakpoint is identical, you get a cache read billed at a tenth of the normal input rate. If anything differs, you pay full price plus a write premium (1.25x on the default 5-minute TTL) to create a new entry.

So "the system prompt is basically the same" counts for nothing. It's either byte-identical or it's a miss.

Bug 1: why did a timestamp give me a 0% cache hit rate?

Because it was the first line of the system prompt. Months earlier I'd added this so the interviewer could say "good morning" at the right time of day:

``` def build_system_prompt(session): return ( f"Current time: {datetime.now():%H:%M:%S}\n" f"{PERSONAS[session.style]}\n" f"{RUBRIC}\n" f"Candidate resume:\n{session.resume_text}" ) ```

Seconds precision. Every turn had a different first line, so every turn had a different prefix, so every turn wrote a fresh cache entry that nobody ever read. I was paying the 1.25x write premium on 1,412 calls to cache prompts that expired unused. Caching made it more expensive than not caching.

The fix: move anything volatile after the breakpoint. The time of day went into a short second system block with no cache_control:

``` system=[ {"type": "text", "text": stable_prefix(session), "cache_control": {"type": "ephemeral"}}, {"type": "text", "text": f"Local time: {now:%H:%M}"}, ] ```

I redeployed and checked the logs. Hit rate: 66%. Better. Not 90-something, which is what the math said it should be.

Bug 2: why did Python set ordering break my cache?

Because Python randomizes string hashing per process, so iterating a set of strings gives a different order in each process. My tool list came from this:

``` enabled = {"score_answer", "ask_followup", "end_interview"} tools = [TOOL_DEFS[name] for name in enabled] ```

Inside one process the order is stable. But I run 4 uvicorn workers, and each worker got its own hash seed. Tools come first in the cache prefix, so four orderings meant four different prefixes for the same session.

This also explains 66% exactly. A session's turns land on workers at random. Each worker misses once per session (the first time it sees that session), then hits. With 4 workers and 12 turns, the expected number of distinct workers touched is 4 × (1 − 0.75^12) ≈ 3.87. So about 3.9 misses per 12 turns, about 8.1 hits, about 68%. My measured 66% sat right on top of the prediction, which is the most satisfying thing a bug has done for me all year.

The fix is boring:

``` tools = [TOOL_DEFS[name] for name in sorted(enabled)] ```

I also started serializing tool schemas from a frozen JSON file instead of building them from dicts at runtime, so nothing upstream could reorder keys either.

Hit rate after redeploy: 91%.

Bug 3: why does a short prompt never get cached?

Because there's a minimum cacheable length per model, and below it the API silently skips caching. On the model I use it's 1,024 tokens; smaller models need more, so check the docs for yours.

Two of my three interviewer styles had long persona blocks. The third, a deliberately terse "rapid-fire" style, came to about 900 tokens before the resume got appended. For candidates who uploaded a one-page resume, the whole stable prefix stayed under the threshold. Those calls showed cache_creation_input_tokens: 0 and cache_read_input_tokens: 0. No error. The breakpoint simply did nothing.

I moved the shared rubric above the persona so every style's prefix starts with the same 2,000+ tokens. That pushed every variant over the minimum, and it means the rubric portion is shared across styles too.

Final hit rate: 94%. The remaining 6% is the first turn of each session, which has to write the cache, plus sessions where the candidate paused longer than 5 minutes and the entry expired.

How much did fixing prompt caching actually save?

Input token cost per session fell 58%. Here's the math on an average 14-turn session, counted in "full-price token equivalents":

Two things jump out. First, the broken version was 18% worse than having no caching at all, because of the write premium. Second, history is now the biggest line item, so the next step is a second breakpoint on the conversation itself. You get up to 4 breakpoints per request; I was using one.

Latency improved too. Time to first token on cached turns dropped noticeably, which matters a lot in a voice product where every few hundred milliseconds feels like an awkward silence. I don't have a clean before/after on that because other changes shipped the same week, so I won't put a number on it.

How do you check if Claude prompt caching is working?

Log the three usage fields on every response and alert when reads stay at zero. This is the code I should have written on day one:

``` u = resp.usage log.info( "cache", read=u.cache_read_input_tokens, write=u.cache_creation_input_tokens, uncached=u.input_tokens, prefix_hash=hashlib.sha256(prefix_bytes).hexdigest()[:12], ) ```

The prefix_hash line is the one that cracked bug 2. I hash the serialized tools plus the stable system block locally and log it. When two turns of the same session showed different hashes, I diffed the two request bodies and the reordered tool list was right there in the first 40 bytes.

A checklist I now run on any cached prompt:

Nothing volatile before the breakpoint. No timestamps, request IDs, random few-shot picks, or "user is on page X."

Deterministic ordering everywhere. Sort sets. Freeze tool schemas. Watch out for dict merges that depend on input order.

Check the length. If cache_creation_input_tokens is 0 on the first call, you're under the minimum.

Put shared stuff first. Content shared across variants goes at the top so it caches across all of them.

Alert on a 0 read rate. A cache that silently stops working looks exactly like a cache that never worked.

So why was my Claude prompt caching hit rate 0%?

Claude prompt caching requires a byte-identical prefix up to the cache_control breakpoint, and my prefix changed on every single call because the first line of the system prompt was a seconds-precision timestamp. Fixing that exposed two more silent failures: Python's per-process hash randomization reordered my tool definitions across 4 workers (capping hits at 66%, exactly what the math predicted), and one prompt variant fell under the minimum cacheable length. Moving volatile text after the breakpoint, sorting the tools and padding the shared prefix took the hit rate from 0% to 94% and cut input cost per session by 58%. None of it threw an error. The only signal was cache_read_input_tokens, so log it.

Written by the developer behind Preterview, an interview prep platform.
参考来源: DEV Community
AI
The Hidden Mechanics of B2B SaaS Seat Traps, Auto-Renewal Windows, and Client-Side Fetch Interception in Manifest V3 配图

The Hidden Mechanics of B2B SaaS Seat Traps, Auto-Renewal Windows, and Client-Side Fetch Interception in Manifest V3

核心内容
文章主要探讨了B2B SaaS采购和前端工程中的“静默状态转换”问题,包括SaaS计费系统如何通过“僵尸座位”和合同自动续订窗口来增加年度续订额,以及前端团队如何因为测试HTTP状态码而遇到的问题。
为什么重要
这个内容值得关注,因为它揭示了B2B SaaS市场中存在的暗黑模式,这些模式可能增加了企业的成本,并影响了前端开发的效率和用户体验。同时,文章提出的技术解决方案对于开发者来说具有实际的应用价值。
关键洞察
文章最有价值的观点包括:SaaS计费系统如何通过“僵尸座位”和自动续订窗口来增加收入,以及如何使用Manifest V3的window.fetch拦截模式来审计供应商的计费页面和模拟HTTP边缘情况。
潜在影响
谁会受影响包括B2B SaaS供应商、采购团队、前端开发者和最终用户。可能产生的变化包括:企业对SaaS采购的透明度提高,成本控制更加严格;前端开发者能够更有效地测试和优化应用;用户可能会获得更稳定和可靠的服务体验。

Modern B2B SaaS procurement and frontend engineering share a common blind spot: silent state transitions. On the procurement side, SaaS billing systems use silent seat promotions ("zombie seats") and 30-to-60-day contractual auto-renewal cutoff windows to inflate annual renewals by 25% to 40%. On the engineering side, frontend teams frequently ship broken billing, rate-limit, and quota-upgrade modals because testing HTTP 402 Payment Required or 429 Too Many Requests states against live production APIs requires backend staging overrides.

展开全文收起全文剩余 48 段 · 约 15 分钟

Here is a technical look at how B2B SaaS seat traps and retention flows operate under the hood, followed by a clean Manifest V3 MAIN-world window.fetch interception pattern that lets you both audit vendor billing pages and deterministically mock HTTP edge cases locally in Chrome.

1. Teaser: 5 B2B SaaS Billing & Seat-Expansion Mechanics (From Our 120-Vendor Dataset)

When auditing SaaS spend across engineering and product orgs, the highest-dollar leakage rarely comes from base plan tiers. It comes from default-open seat permissions and contractual notice windows:

(The table above is a 5-row teaser from our **120-Vendor B2B SaaS Cancellation Dark-Patterns, Retention Discounts & CFO Negotiation Playbook* bundled inside SubKill below).*

2. Deterministic Client-Side window.fetch Interception in Manifest V3 (MAIN World)

When building SaaS billing UIs—or inspecting how a web application handles subscription state—Chrome's declarativeNetRequest API in Manifest V3 cannot dynamically synthesize stateful JSON response bodies with custom latency and status codes on the fly without data-URI workarounds.

Instead, by registering a content script with world: "MAIN" and run_at: "document_start", you can wrap window.fetch before the application bundle initializes, inspect outgoing REST/GraphQL payloads, and deterministically short-circuit matching routes with synthetic 402 Payment Required, 429 Rate Limit, or 500 Internal Server Error responses:

``` // Manifest V3 MAIN-World Fetch Interceptor & Deterministic Mock Override (Teaser Snippet) (() => { const ORIGINAL_FETCH = window.fetch.bind(window); let activeMockRules = [];

// Listen for rule updates bridged from the ISOLATED content script / popup window.addEventListener('message', (event) => { if (event.source === window && event.data?.type === 'RESTGUARD_SYNC_RULES') { activeMockRules = Array.isArray(event.data.rules) ? event.data.rules : []; } });

window.fetch = async function (input, init = {}) { const url = typeof input === 'string' ? input : (input?.url || ''); const method = (init.method || (typeof input === 'object' && input?.method) || 'GET').toUpperCase(); const startTime = performance.now();

// Check if an active local override rule matches this URL and HTTP method const matchedRule = activeMockRules.find( (r) => r.enabled && url.includes(r.urlPattern) && (r.method === 'ANY' || r.method === method) );

if (matchedRule) { if (matchedRule.delayMs > 0) { await new Promise((resolve) => setTimeout(resolve, matchedRule.delayMs)); } return new Response(matchedRule.responseBody, { status: Number(matchedRule.statusCode) || 200, headers: { 'Content-Type': 'application/json', 'X-RestGuard-Mocked': 'true' } }); }

const response = await ORIGINAL_FETCH(input, init); const durationMs = Math.round(performance.now() - startTime);

window.postMessage({ type: 'RESTGUARD_REQUEST_LOG', payload: { url, method, status: response.status, durationMs, timestamp: Date.now() } }, '*');

return response; }; })(); ```

Get the Complete Manifest V3 Chrome Extensions & Engineering Kits

All of our Chrome extensions ship as 100% local, zero-telemetry Manifest V3 packages (Load Unpacked ready in chrome://extensions) with full unminified source code included (use code STACKOPS20 on Payhip for 20% off):

SubKill: SaaS Trial-Trap, Zombie Seat & Retention Discount Detector Chrome Extension (MV3) + 120-Vendor Cancellation Playbook ($24)

Automatically detects 120+ B2B SaaS billing/pricing domains in Chrome, surfaces hidden 25%–60% retention discount triggers, flags zombie-seat rules, and includes the full 120-Vendor Cancellation & CFO Negotiation Master CSV.

Payhip ($24): https://payhip.com/b/wYFls

Ko-fi Shop ($24): https://ko-fi.com/s/3171d1e51c

RestGuard: Local API Request Interceptor, Mock Response Override (200/402/429/500) & cURL Generator Chrome Extension ($19)

Intercept live window.fetch traffic, deterministically mock 200, 402, 429, and 500 JSON responses without backend changes, and copy any live request as a ready-to-run cURL command in one click.

Payhip ($19): https://payhip.com/b/HREKh

Ko-fi Shop ($19): https://ko-fi.com/s/0dde09da87

Anti-AI-Slop UI Design Systems Pack: 12 .cursorrules & CLAUDE.md Themes + Live HTML Switcher ($24)

12 deterministic B2B SaaS UI design token specs (Linear Dark, Stripe Editorial, Vercel Geist, Raycast, Bloomberg Terminal, Supabase, Notion, Retool, PostHog, Mercury, Cron, Tailwind Catalyst) + interactive HTML theme switcher.

Payhip ($24): https://payhip.com/b/S90xh

Ko-fi Shop ($24): https://ko-fi.com/s/9215e0ddd5

PromptDock: AI Prompt Vault, {{Variable}} Injector, Token Counter & Chat-to-Markdown Chrome Extension ($19)

Inject reusable {{variable}} system prompts into ChatGPT, Claude, Gemini, and Perplexity, estimate token costs, and export entire chat threads to clean Markdown (.md) or JSON.

Payhip ($19): https://payhip.com/b/FXdnA

Ko-fi Shop ($19): https://ko-fi.com/s/1eff7ef5ed

StackRay: B2B Lead, Tech-Stack, Email & Live DNS/MX X-Ray Chrome Extension ($24)

Extract 22+ SaaS tech signatures, on-page contact emails, and live MX/SPF email gateways via Cloudflare 1.1.1.1 DNS-over-HTTPS, with 1-click CSV export.

Payhip ($24): https://payhip.com/b/PaTIx

Ko-fi Shop ($24): https://ko-fi.com/s/7afe83cb8d

StealThisUI: Website Design System, Color Palette, Typography & Cursor/Claude Code Prompt Chrome Extension ($19)

Extract live window.getComputedStyle() tokens from any reference website into a ready-to-paste CLAUDE.md / .cursorrules specification.

Payhip ($19): https://payhip.com/b/YV03s

Ko-fi Shop ($19): https://ko-fi.com/s/ceebb81dca

CiteCheck: Technical SEO, Schema.org JSON-LD & AI Search (/llms.txt + GPTBot) Auditor Chrome Extension ($19)

Audit on-page SEO hierarchy, Schema.org @graph JSON-LD nodes, and live /llms.txt + robots.txt AI crawler permissions in one click.

Payhip ($19): https://payhip.com/b/BJH0K

Ko-fi Shop ($19): https://ko-fi.com/s/6a301e5e45

All-Access Flagship Engineering, Security & FinOps Vault ($49 — $790+ Combined Value)

Payhip Vault ($49): https://payhip.com/b/LeIsO

Ko-fi Shop Vault ($49): https://ko-fi.com/s/c1340c6028

参考来源: DEV Community
美光崛起背后:美国内存“独苗”的生存战、资本博弈与AI重生 配图

美光崛起背后:美国内存“独苗”的生存战、资本博弈与AI重生

核心内容
文章主要讲述了美光公司在存储芯片行业的崛起历程,以及其在面对行业价格周期波动和竞争压力下的生存策略,同时探讨了AI技术对美光业绩的推动作用。
为什么重要
这篇文章重要,因为它揭示了美光作为美国内存行业的“独苗”如何在激烈的市场竞争中生存并崛起,以及AI技术对内存行业的影响。它反映了全球半导体行业的竞争态势,对理解美国内存产业的现状和未来趋势具有重要意义。
关键洞察
美光能够在行业洗牌中生存下来,主要得益于其独特的“美国与东亚二象性”策略,即在美国国内市场保持高端产品的领先地位,同时在东亚市场通过成本控制策略竞争低端市场。此外,AI技术的兴起也为美光带来了巨大的业绩增长。
潜在影响
美光的崛起和AI技术的发展可能会对全球内存产业产生深远影响。首先,美光的成功可能激励其他美国半导体企业加大研发投入,提升竞争力。其次,AI技术的广泛应用可能导致内存需求持续增长,从而推动内存产业整体发展。最后,全球半导体供应链可能会因为美光的崛起而发生调整。

硅谷101

2026.10.18 15:55

展开全文收起全文剩余 160 段 · 约 29 分钟

· 来自上海

全文13666字

00:00 / 41:58

独特的“美国与东亚二象性”

文 | 硅谷101

9月30日,美光再次交出了一份创纪录的财报。

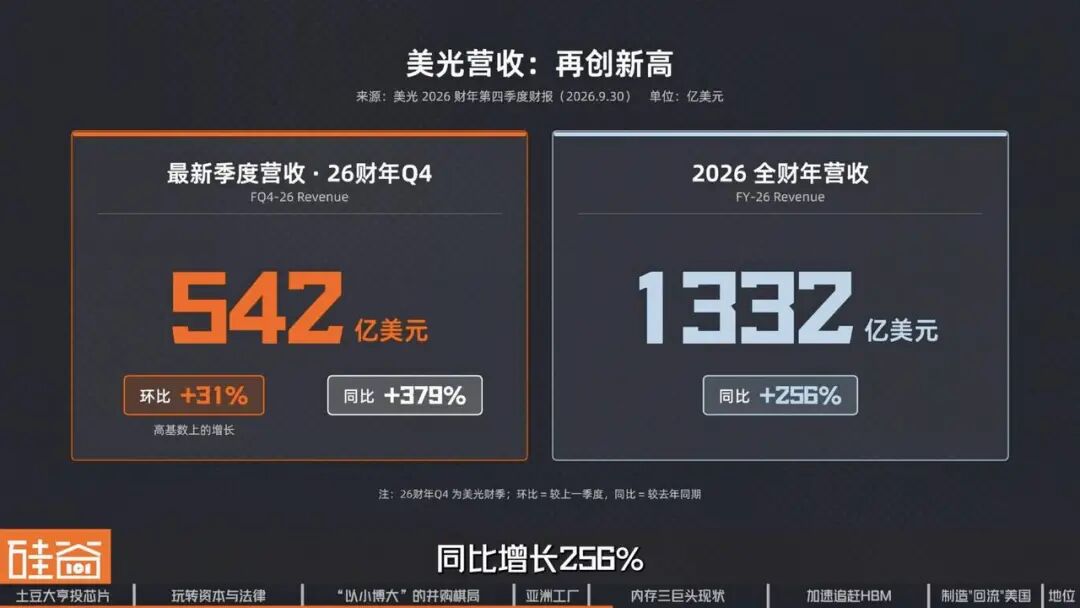
2026财年第四季度,美光单季营收达到542.3亿美元,营业利润率达到80.7%,营收与净利润双双刷新纪录。AI带来的强劲需求,正在让这家存储芯片公司迎来历史上最赚钱的时刻。

但回顾美光近五十年的历史,它的成长远没有今天的业绩看起来那么顺利。在存储行业残酷的价格周期中,许多曾经的巨头相继退出,而美光却一次次熬过亏损和行业洗牌,最终成为美国内存行业的“独苗”。

在这个过程中,美光逐渐形成了一套特殊的生存方式:背靠美国的资本市场,通过一系列“以小搏大”的收并购布局,将制造业务不断向亚洲延伸。如今,这家美国存储巨头的绝大部分产能都在亚洲,而美国政府正拿出数十亿美元补贴,希望将它的先进制造能力重新带回美国。

这一切的起点,却是在远离硅谷、素有美国“土豆之州”之称的爱达荷州。在一家牙科诊所的地下室里,美光迈出了创业的第一步。而它进入存储芯片制造业的入场券,竟是来自一位靠给麦当劳供应冷冻薯条的“土豆大亨”。

从靠本地商人投资起步,到借助美国资本、亚洲制造不断扩张,再到今天成为AI供应链上的关键公司,美光究竟凭什么一次次活过行业低谷?过去近五十年的生存经验,又能否帮助它赢下下一轮AI竞争?

虽然身处“土豆州”,但美光不是一家从石头缝里蹦出来的公司。它的源起,是一家在早期半导体史上很重要,但现在已经很少有人提起的公司:Mostek。

Mostek成立于1969年,创始人出身于德州仪器。在DRAM还处于4K、16K的时代,Mostek曾经拿到过很高的市场份额,是早期DRAM行业中的重要玩家。美光的4位创始人中,有3位是Mostek的前员工。

1978年,美光在博伊西(Boise)的一家牙医诊所的地下室成立。当时的美光并没有任何制造的业务,他们的全部业务,就是给Mostek做半导体的设计咨询。

远离硅谷的美光并没有按照今天我们熟悉的剧本,拿VC(风险投资)的钱,而是拿了几个本地“乡绅”的钱。这样的融资方式,其实很像早期的星巴克。就是本地的几个成功商人觉得这几个小伙子不错,一合计,每人投点钱支持一下。

但只过了一年,这家年轻的公司就遭到了当头一棒。1979年,Mostek被联合技术收购后,美光失去了Mostek的合同,仅有的收入来源没有了。

没了唯一的客户之后,美光决定自己造芯片。建工厂需要更多的钱。在那几个本地“乡绅”的介绍下,美光的创始人们结识了土豆大亨JR Simplot。

1980年,JR Simplot已经70多岁了,种了一辈子土豆,旗下公司是麦当劳最大的冷冻薯条供应商。没有VC们复杂的尽调和胶着的投委会,在参观了美光在牙医诊所地下室的办公室后,JR Simplot出资100万美元,拿下了美光40%的股权。

一个种土豆卖薯条、早已功成名就不缺钱的老人,为啥要投资一个还在地下室,只有4个人的野鸡公司,做的还是与薯条风马牛不相及的存储芯片。也许,是因为薯条和芯片的英文都是Chips?

当然,Simplot给这100万美元还远不够建厂,但他相当于给了美光一张“信用通行证”。在他的背书下,美光成功从当地银行获得贷款,并陆续从其他爱达荷商人那里筹钱。

但当时,一座DRAM工厂的建设成本已经达到上亿美元,美光就算掏光腰包也拿不出来。

为了把成本压到最低,他们拿一家超市的建筑方案来改造厂房,把原本的肉类冷藏空间扩建成洁净室,同时大量采购了其他厂商淘汰的二手设备。最终,这座5万平方英尺的晶圆厂在1981年建成,成本只花了约700万美元。

1981年,美光开始生产64K DRAM,正式从一家芯片设计公司变成了真正的半导体制造商。而美光这个建厂时机,可以说非常精妙。

1981年,随着IBM PC开始进入市场,个人电脑产业此后快速崛起。DRAM作为电脑不可或缺的核心存储器件,需求随之快速上升。美光凭借更小、更先进的64K DRAM设计,以及相对更低的制造成本,迅速打入市场。

仅仅三年后,1984年6月1日,美光正式在纳斯达克上市。按今天的拆股口径回溯,它的首日开盘价约为1.35美元。

虽然如今韩国占据着全球存储芯片的主导地位,但早期的存储行业,其实是美国公司的天下。英特尔的第一款量产产品就是存储芯片,IBM、德州仪器、AMD、摩托罗拉、国民半导体等美国知名的半导体公司,也都曾经涉足过存储行业。

这种格局一直持续到上世纪80年代,直到存储芯片的竞争,进入了另一套游戏规则。

在这套规则下,国家意志成为产业竞争的幕后推手。一些国家通过动用行政力量,从研发、资金、人才等多个维度定向扶持特定的企业。企业可以不考虑短期的利润和股价表现,维持极高强度的资本开支,甚至在行业下行期也要逆势投资,只为了能熬死对手。

从80年代日本企业的崛起,到后来韩国企业的后来居上,走的都是这条路,连具体的打法都大差不差:我挣不挣钱无所谓,我要的,是你不能活。

于是,日本企业用它挤垮美国企业,韩国企业后来又用它挤垮日本企业。在这样残酷的竞争下,美国几乎全部的半导体公司都退出了存储业务,只剩下美光这一个独苗。

杨倚歌

阳光保险资产证券研究部科技组组长

存储与代工很相似,是资本密集度很高的行业,需要大量的产能制造及资本开支来维持工厂的运营。存储周期下行时,当期利润无法覆盖重资产折旧,许多公司便在这一阶段破产。

技术环节最核心的技术壁垒,仍集中在美国和欧洲,部分上游材料和零部件集中在日本,中国台湾和韩国则受益于较低的制造成本,以及早期的政府扶持。

但是,在这样的市场格局下,为什么只有美光生存下来了呢?毕竟,美国没有国家控制的银行能给美光输血,美国的资本市场也不可能容忍任何一家公司,一边亏钱一边投资。

在这里,我们总结出了一个结论,试着回答一下上面的问题:美光身上具备一种“美国东亚二象性”,它同时兼具着美国性和东亚性,还把两边的优点结合的特别好。

▍美光的“美国性”

美光首先是一家美国公司,这对于理解美光的成功很重要。美光的美国性首先体现在,它可以背靠美国发达的资本市场和灵活的金融工具,在行业低谷期,借助美国公司的身份,用极其精明的资本运作,低价扩大自身产能。

来看一个早期的案例:1998年,美光买下了德州仪器的存储业务。交易细节十分有意思,乍一看,这是一桩价值8亿多美元的交易。但实际上,美光一毛钱的现金也没出。美光付出的,是价值8亿多美元,定向增发的股票和9.5亿美元的公司债券。

德州仪器不仅没有收到现金,还给美光提供了7.5亿美元融资,用于将收购后的工厂改成美光的生产工艺。是的,你没有看错,是卖方德州仪器另外拿出7.5亿美元现金给美光。

1998年是存储行业周期性的低点,德州仪器急于将亏损严重的存储业务甩掉。美光就这样不花一毛钱现金,拿下了德州仪器的全部存储业务,还顺手拿到了大把专利的交叉授权。

除了成熟的资本运作外,美光的“美国性”,还有一个常被忽略的维度:法律。从上世纪80年代开始,美光就一次次把美国的贸易和司法体系变成自己的竞争工具。

1985年,当日本厂商在DRAM市场把美国同行打得溃不成军时,美光向美国政府提起反倾销申诉,最终推动美国对日本DRAM展开调查,并促成了1986年的《美日半导体贸易协定》。

90年代面对韩国厂商崛起,美光又发起反倾销调查。2002年,在收购海力士失败后,美光进一步推动了针对韩国DRAM补贴的调查,最终海力士被征收高额反补贴关税。

但美光最经典的一次“法律操作”,还是DRAM价格操纵案。

2002年,在美国司法部调查多家DRAM厂商串通涨价时,美光率先向司法部举报并申请宽大处理,成为第一家主动配合调查的涉案企业,提供了卡特尔运作的关键证据并持续配合调查。

最终,三星、海力士、英飞凌、尔必达等同行被处以巨额罚款,而美光作为宽大政策下的吹哨者,既没有被刑事起诉,甚至没有缴纳任何罚款。

所以,美光的美国身份带来的,除了成熟的资本运作外,还有着一套天然熟悉、且能够借力的美国法律和监管体系,帮它在竞争最激烈的时候,去改变游戏规则。

不过,这两点优势其他美国企业也有,那为什么他们都退出市场了?这其实跟美光业务的特殊性有关。当时美国市场上的存储芯片玩家,比如英特尔、IBM、德州仪器等等,他们都拥有更多高利润业务,存储只是他们一个分支。

杨倚歌

阳光保险资产证券研究部科技组组长

IBM、德州仪器或英特尔等公司,本质上它们还有其他业务可以发展。例如,德州仪器可以做模拟芯片,英特尔可以做CPU,IBM是ODM的电脑制造商。这些公司有其他主业支撑,因此在那一轮行业出清之后,把存储的业务该卖的卖,该收给别人给收了。

但美光不同,它没有其他业务,从成立起就它就只专注存储。存储行业越是低迷,它越没有退路,也越必须想办法熬过去。而这些本土巨头的危机,就被它视为逆风翻盘的机会。

后来,美光也把这种思路带到了东亚市场。

▍美光的“东亚性”

从2008年开始,美光完成了几笔极其精明、让人拍案叫绝的交易,直接造就了如今的存储三巨头格局的行业大洗牌。也是在这个阶段,在保持自身美国性的同时,美光在产能端逐渐开始东亚化。

奇梦达是德国英飞凌拆分出来,专注于存储业务的公司,是当年欧洲存储行业“全村的希望”。2008年金融危机后,存储价格暴跌,奇梦达现金流极度紧张。就在奇梦达挣扎在生死线上时,美光来了。

华亚科技,这是一家由台湾南亚科技和英飞凌联合成立,专注于DRAM制造的企业。奇梦达从英飞凌拆分后,华亚科技的股权也被转移给了奇梦达。2008年,奇梦达持有约35%的华亚科技股权。

这一次,美光没有再玩换股的把戏,爽快的以约4亿美元现金,收购了奇梦达持有的全部华亚科技股权。

在这4亿美元现金中,华亚科技自己拿出8500万美元借给美光,南亚科技的母公司南亚塑胶借给美光2亿美元,美光真正自己拿出的现金只有约1.13亿美元。

也就是说,美光只用了约1.13亿美元的自有现金,就拿到了华亚科技约35%的股权。一起收入囊中的,还有华亚科技约50%的产能分配权,和向华亚科技导入美光工艺的权利。

导入美光工艺的成本谁来出?反正美光肯定不出。

一年后的2009年8月,华亚科技增发约3.1亿美元股票,用于把工厂转换到美光的工艺。此时的股价也已回升,美光确认了数千万美元的会计收益。

但华亚科技是注定要被美光吃干抹净的。2015年12月,美光以约41亿美元,收购剩余华亚科技股份。这41亿美元中,有约25亿美元,是由本地银行团提供的贷款,抵押物包括华亚科技的厂房,土地和部分设备,约10亿美元是向卖方南亚科技定向增发的股票。所以算下来,美光只花了6亿美元自己账上的现金,就完全收购了华亚科技的剩余股份。

收购后,华亚科技正式改名为“美光晶圆科技台湾”(Micron Technology Taiwan,MTTW)。

接着,时间来到2012年,这也是美光在AI爆发之前的一个高光时刻。这一年,日本的“存储国家队”尔必达申请破产保护,这是日本历史上最大的制造业破产案。

没有任何意外,美光又来了。美光以2000亿日元,按当时汇率计算大约25亿美元的价格,获得了尔必达100%的股权。

但美光会老老实实的拿出2000亿日元的现金吗?当然不可能。达成交易时,美光只拿出了600亿日元的现金,当时约合7.5亿美元。而剩下的1400亿日元约合17.5亿美元,是被安排在交易完成之后的6年分批付款。具体的安排是,2014年到2017年,每年付款200亿日元;2018年到2019年,每年付款300亿日元。

1400亿日元,6年才付清,这条件够苛刻了吧?但这还不够。这1400亿日元的具体付款方式是,尔必达成为美光的全资子公司后继续生产DRAM,美光向尔必达支付晶圆制造费、研发服务费和管理服务费。这些费用以美元计价,尔必达用继续生产产生的现金流支付给债权人,以日元计价。

除此之外,美光还在继续“挣”汇率的钱。

交易在2012年7月达成,当时美光只付了很少一点保证金。到交割完成时,时间已经到了2013年8月。在这期间,日元兑美元的汇率从约80比1跌到了约98比1。也就是说,真正到了交割日,美光付出的600亿日元现金,已经从约7.5亿美元,下降到了约6.15亿美元。而后面分批付款的这6年中,日元兑美元的汇率进一步下跌,最终付出的钱远低于25亿美元。

但省下了这么多钱其实还不是重点,更重要的是它还借收购尔必达,拿下了台湾瑞晶电子。尔必达在破产时持有台湾瑞晶电子(Rexchip)约65%的股权,瑞晶电子是尔必达和力晶科技合资成立的DRAM生产企业,是尔必达重要的产能基地。

美光收购尔必达后,继承了尔必达持有的瑞晶电子约65%的股权,同时与力晶及其关联方单独签署了收购瑞晶电子24%股权的协议。这笔单独的收购价值约100亿新台币,约合3.34亿美元。非常罕见,这3.34亿美元是美光直接付的现金。

2013年交易完成时,美光持有24%+65%,合计约89%的瑞晶电子股权。转年到了2014年,美光又以约1.46亿美元的价格,从金士顿手上买下了9.9%的瑞晶电子股份,将持股比例上升到了超过99%。而瑞晶电子就是现在的美光记忆体台湾(Micron Memory Taiwan,MMT)。

杨倚歌

阳光保险资产证券研究部科技组组长

尔必达破产时,债务压力很大。它那时长期面临良率较低、产能爬坡缓慢的问题,又正好遭遇了行业周期的影响。付款折现后的价值,也明显低于其面值。

对于日本政府和债权银行而言,只有大公司作为买家,能具备相应运营能力,并能承担大部分员工与债务。对美光来说,这笔收购带来了更多技术、产能和员工。美光相当于在行业周期较低的位置,以非常便宜的股期价格,买入了一份未来行业可能形成寡头格局后的看涨期权。

现在回过头来看,完全可以说,对尔必达和瑞晶电子的收购,是美光历史上最重要的收购,也是美光今天成为万亿巨头的基石。

美光在获得了尔必达的广岛DRAM晶圆厂、秋田封装测试厂、瑞晶科技的台中DRAM晶圆厂之后,当时的总产能从世界第四,变成了仅次于三星的世界第二。

从战略上来看,此前美光更强的是PC和服务器DRAM,但尔必达在手机、平板和低功耗DRAM领域有很强优势。所以,这个收购补齐了美光的移动产品线,美光也在之后成为了苹果的DRAM供应商。获得这一切,美光只掏了很少一点自有现金。

当然美光也不是没有失手的时候。在我们海力士的那期中其实也提到过,美光曾经差一点就把海力士收入囊中。但因为它提出的价码太为苛刻,虽然债权银行同意了,但却遭到了海力士全体董事一致否决。

海力士在拒绝美光收购后又熬了10年,终于等来了SK集团的收购。随后大胆押注HBM,成为了AI时代的大赢家。

想象一下,另一个平行宇宙里,美光如果成功收购海力士,现在的存储格局就不是三巨头了,大概率会是美光和三星的双寡头。而如果没有独立的海力士在早期押注HBM,英伟达的H100没有如期上市或性能不佳,今天AI的爆发或许都会延后。

在完成了这些收购后,我们就不能单纯地以一家美国公司来看待美光了。因为从最核心的晶圆制造角度讲,美光几乎可以被看作是一家东亚公司。

截至目前,美光在美国本土仅有弗吉尼亚马纳萨斯(Manassas)一座工厂,产量仅占全球存储供应的约 2%。而其他绝大部分的产能都位于亚洲基地。其中,先进DRAM与HBM的核心制造和配套基地,集中在桃园、台中、苗栗铜锣和台南四座城市。

桃园是美光最早的DRAM基地之一,核心是Fab 11。新建的Fab 11E将引入EUV,计划于2028年投产。

台中的规模最大,既承担先进DRAM晶圆制造,也是HBM封装测试的重镇。目前当地已有两座先进封装厂,第二座于2026年10月启用。

苗栗铜锣是最新扩张的DRAM基地。2026年,美光以18亿美元买下力积电的P5厂,并在建设第二座晶圆厂。

台南则是晶圆测试基地,由收购友达的旧厂房改造而来,专门为桃园、台中的DRAM扩产提供配套,首批设备已于2026年9月进驻。

日本则以广岛Fab 15为核心,承担先进DRAM晶圆制造。这座工厂来自美光2013年收购的尔必达,目前正在升级,以支持未来DRAM节点和AI内存生产。

新加坡则是美光最重要的NAND制造基地,目前美光约98% 的NAND产能都来自这里。随着 AI 时代存储需求激增,美光还正在新加坡双线扩产:一座约240亿美元的新NAND晶圆厂已于2026年初动工、计划2028下半年投产。同时,一座约70亿美元的HBM先进封装厂也在建设中,预计2027年起贡献HBM产能。

杨倚歌

阳光保险资产证券研究部科技组组长

美光是政治上的美国公司,运营上的东亚公司。从运营角度看,无论哪家公司,在美国建厂肯定都没有太大的优势。

以台积电赴美建厂为例,其毛利率会受到两到三个百分点的稀释。美国工厂的产能爬坡、员工加班意愿等,对台积电来说也是无法保证的事情。我认为对美光来说也一样,只不过与台积电不同,它是政治上的美国公司。

美光身上的东亚性,也解释了我们心中的一个疑问:美国制造业问题重重,在半导体制造这个最注重效率,最依赖高素质工程师的行业中,美光作为一家美国公司,是如何搞定制造的。

现在答案来了,因为人家的产能基本就不在美国。不过,现在也随着AI竞争的加剧,这样的格局也开始发生着变化。

我们先来看看,美光现在在整个存储行业中处于一个什么位置。

▍美光的业务现状

如果单纯看公司规模,全球真正能够称得上内存巨头的,其实就三家:三星、SK海力士和美光。

而从营收规模和产能体量上来看,美光是这三家中最小的。以2026年二季度的财务数据为例,SK海力士营收约合550亿美元,美光同期营收约414.6亿美元,三星半导体业务营收约为877亿美元。

产能方面,差距更大。据 SemiAnalysis估算,到2026年底,三星的DRAM月产能约为72万片、海力士约 59.5 万片,美光约为38.5万片。在最关键的HBM上,截至2025年底,海力士、三星的月产能都在16 万到17万片上下,美光却只有约6万片,大约只有两家的三分之一。

但是,要是从最近几个季度的增长速度来看,美光却是这三家中跑得最快、最会赚钱的。

最新一个季度的财报显示,美光营收已达到542亿美元,在高基数上又增长了31%。2026年全财年营收1332亿美元,同比增长256%。营业利润率也从2025年初的约25%,升至80%以上,并在2026年二季度反超海力士,成为三家第一。

为什么美光最近的爆发力这么强呢?这背后其实跟它的业务结构相关。

三星的业务比较复杂,它身上有着代工和芯片设计这些利润率偏低的包袱,我们这里先不做对比。但美光和海力士的业务其实是高度相似的,二者可以放到一起来看看。

美光和海力士的业务都主要由DRAM和NAND两大块构成,并且占比很类似,都是DRAM占了接近八成,NAND大约占两成。其中,DRAM内部也是分为两条线,一条是传统DRAM,主要是服务器用的DDR5、手机平板用的LPDDR这些通用内存。另一条则是HBM,也是造成差别的最重要原因。

海力士很早就开始押注HBM,几乎把身家性命都压了上去。它在2013年就和AMD共同推出了HBM1,接着一代一代往前推,把越来越多的DRAM产能腾出来专门造HBM。到现在,它大约有三成的DRAM 产能都用在了HBM上,到2027年这个比例预计会升到接近四成。

这份早早下注、重仓投入的决心,换来了它今天在HBM上近乎垄断的领先地位:全球HBM市场里,海力士一家就拿走了约六成的份额,是当之无愧的王者。

相比之下,美光起步很晚。它直到2020年才推出首款HBM产品,而那时海力士和三星早已交付过HBM、HBM2两代产品。这也造成了,如今HBM大约只占美光DRAM收入里的两成,但海力士的HBM,几乎占据它DRAM收入的半壁江山。

这里面,藏着一个这一轮周期里最关键、也最反直觉的变化,那就是涨价得最凶的,其实不是HBM,而是被冷落的传统DRAM。

因为三巨头都忙着把产能转去做利润更高的HBM,结果服务器、PC、手机用的这些通用内存,供给被抽走了一大块,全面陷入短缺,于是价格一飞冲天。

数据显示,2026年一季度,传统DRAM合约价环比大涨90%以上,二季度还在继续涨。但反观HBM,因为几家龙头大多是跟大客户签的早期锁价的长期协议,价格反而被提前摁住了。

杨倚歌

阳光保险资产证券研究部科技组组长

HBM的合约与过去的传统DRAM、NAND合约不太一样,传统的DRAM和NAND也有长期协议,但通常按季度或半年议价,价格更接近随行就市,只锁量不锁价,也没有赔付款。HBM最早出现就是为了AI服务的,一直都是以一年一谈价,大多在每年年底前后确定。

也就是说,今年的HBM价格在去年年底定下来的,而当时整个存储市场还没有开始疯狂涨价。

于是最近就出现了这样一个局面:海力士HBM卖得最多,但价格恰恰被长约锁死。当它把产能都倾斜给HBM,留给传统DRAM的产能也自然就被挤压了。

美光的处境正好相反。放在过去,HBM占比低是美光被诟病的短板。可偏偏在这一轮,通用DRAM涨得比HBM更猛,美光这块更大的敞口,反而让它更充分、更直接地吃到了这波涨价红利。这种“更均衡的应用结构”,如今常被HBM的光环盖过,但其实是美光现阶段的最大优势之一。

美光目前的业务收入被划分为四块,分别为云内存、核心数据中心、移动与客户端、汽车与嵌入式。最新一季度的数据显示,这四块业务的收入,分别为162.8亿美元、180亿美元、131.1亿美元和68.2亿美元。虽然数据中心相关的两块业务仍然是大头,但移动、客户端、汽车和嵌入式业务合计仍贡献了约37%的收入,是一块相当可观的基本盘。

尤其是在汽车和工业市场,美光积累了长期的客户和认证壁垒。这些业务增长可能没有HBM快,却胜在稳定、认证壁垒高、客户黏性强,是典型的“压舱石”类的业务。

Rob Li

纽约Amont Partners管理合伙人

海力士发布季报后,市场认为其Operating Income(营业利润)低于预期,股价当天跌了十多个点。一个核心原因在于,HBM在海力士业务中的占比最高。

在以前这是好事,市场会很喜欢,因为HBM是最高端的产品。但从去年第四季度到今年上半年,普通内存价格也涨得很厉害,而HBM消耗更多晶圆,成本比普通内存更高,因此导致这一阶段的毛利率反而不及普通内存。

换句话说,在相同产能条件下,分配给HBM的资源越多,对公司整体毛利率就形成了拖累,而不是助力。

但是,当前传统内存毛利率更高只是阶段性的,HBM依然是未来制胜的关键。

▍竞争焦点:HBM

如今,HBM正在成为存储行业穿越周期的一个关键变量。过去,DRAM和NAND高度标准化,存储芯片更像一种“大宗商品”,价格和利润随着供需周期剧烈波动,厂商很难维持稳定的盈利能力。

但HBM不同,它需要跟特定客户的特定芯片深度协同设计,要通过定制认证,每家的堆叠和base die方案也有所不同,更接近非标准化的“定制产品”。因此,它技术门槛更高,客户验证周期也更长。

随着AI算力需求持续增长,HBM不仅带来了更高的单价和利润率,也让存储厂商获得了更强的订单确定性和议价能力。

所以,今天市场所说的“存储价值重估”,关注的并不是最近存储芯片的涨价,更在于HBM正在改变这个高度周期性行业的盈利模式,让周期变弱、更平滑。

杨倚歌

阳光保险资产证券研究部科技组组长

如果仍按照过去随行就市的方式,每季度依据合约价议价,那么传统DRAM和NAND占比越高,周期风险反而越大。只有HBM这类有长期协议、有需求景气度的产品占比高的时候,抗周期性和盈利稳定性才能提升。

所以美光也很清楚,在HBM上绝不能掉队。实际上,美光很早就意识到了“堆叠内存”这条赛道的重要性,只是它早年押错了标准。

早在2011年,美光就联合三星、IBM等推出过一种叫HMC(Hybrid Memory Cube,混合内存立方体) 的堆叠内存技术,这个时间点甚至早于海力士押注HBM。这个技术的思路是把多层DRAM裸片,和独立的逻辑控制芯片(Logic Die)混合堆叠在一起,直接把内存控制器安装在内存堆栈内部,依靠TSV硅通孔技术垂直堆叠多层芯片,形成立体方块形态。

HMC在技术上有很多亮点,也一度用在超级计算机、网络处理器等场景。但与HBM相比,传输相同数量的数据,功耗较高,也很难适配本身就是高功耗的GPU,也因此没有被英伟达和AMD采用。

2017年5月,前闪迪联合创始人Sanjay Mehrotra出任美光CEO。他上任后决定不再推进HMC,并转向了已经成为行业标准的HBM,这被普遍认为是美光近年来最重要的一次路线纠偏。

但这时,美光已经在HBM上足足落后了两代,即便是2020年美光推出首款HBM产品之后,研发速度也一直不温不火。2022年6月,海力士已经率先量产HBM3,成为全球首家把HBM3 送进英伟达 H100 供应链的厂商。但美光这边,却迟迟没有动静。

真正让美光扳回一局的,是一个大胆的决定:它干脆跳过了整整一代HBM3,把全部资源押在了下一代HBM3E上。

这一跳,赌对了。2024年2月,美光宣布量产24GB的HBM3E,并挤进了英伟达H200的供应链,而当年二季度就随H200一起出货。从这一代起,美光的追赶明显提速:它接着推出了容量更高的12-Hi HBM3E,又一路向下一代HBM4推进。

到HBM4这一代,美光甚至打了一场漂亮的翻身仗。2026年一季度,它比原定计划提前了整整一个季度,开始量产36GB、12层堆叠的HBM4,带宽超过每秒2.8TB、引脚速率超过11Gbps,功耗比自家上一代降低了两成多。

同年6月,英伟达CEO黄仁勋公开确认,海力士、三星、美光三家都已通过HBM4的认证、进入量产,共同为下一代 Vera Rubin平台供货。这也是HBM历史上第一次,新一代产品一开始就集齐了三大供应商。至此,美光终于甩掉“迟到者”的标签,产品规格上,重新站到了与三星、SK海力士同代竞争的位置。

不过,“能造”和“造多少”,还是两回事。据供应链分析师估算,这一代Vera Rubin的订单分配。海力士一家就拿走了六到七成,三星占两到三成,留给美光的,只是剩下的一小块。从收入份额看,美光在HBM市场只占到20%,距离海力士仍有明显差距。

Rob Li

纽约Amont Partners管理合伙人

在目前阶段,目前几家厂商的Pin Speed(单Pin传输速率)都合乎规格。从美光自身看,它并没有特别强的动力,因为它的产能是三家中最少的。美光多次表示,只要HBM市场占有率能够与自身DRAM产能占比维持一致,就可以接受。从英伟达作为客户的角度看,三家供应商都会使用,最需要的是它们能够保证供应量。

所以对于美光来说,除了技术上的持续追赶之外,未来要跨越的重点,还是被海力士的先发绑定与数倍产能优势牢牢占住的“份额”。不过,HBM的竞争还在继续。下一代的HBM4E,正在成为三巨头的下一个战场。

美光要在HBM4E上,首次把最先进的EUV光刻技术引入量产工艺。但我们的嘉宾认为,转向使用EUV技术,并不意味着就给美光带来了技术上弯道超车的机会。从目前的格局来看,海力士仍然牢牢占据着HBM的头把交椅。

杨倚歌

阳光保险资产证券研究部科技组组长

制程压力越来越大时,就很难不使用EUV。存储是以技术为基础、靠产能规模取胜的行业。大家都采用EUV之后,只能说技术代际拉平了。对于HBM,还要看封装能力,如何楼建的更稳定、更好。目前我认为海力士更好一些,三星和美光大差不差。

还有一点很重要,如果我们仔细留意美光HBM加速追赶的这个时间点,你可能会发现,它恰好发生在美国重振芯片和制造的大背景下,这也让美光如今的身份发生了变化。

过去,美光是美国一家普通的芯片公司。但在AI时代进入白热化竞争的当下,美光已经变成了美国必须保住的一个核心战略资产。

HBM是当下决定AI芯片性能最关键的基础设施之一,在全球能够大规模生产先进HBM的厂商中,美光是唯一一家美国公司。这意味着,如果美国想要掌握从GPU、先进封装到HBM的完整AI供应链,就不能只靠英伟达、AMD这些芯片设计公司,也必须保住美光。所以,美国开始想办法把美光从亚洲“拉回来”。

2022年,美国通过《芯片与科学法案》,把先进半导体制造放到了国家产业政策最重要的位置上。美光作为美国本土唯一内存龙头,成为了最核心的补贴对象。

美国政府给出的条件极具有吸引力,包括直接补贴、贷款、税收优惠,再加上州政府提供的土地和基础设施支持等。

美光给出的回应,是在美国的大规模建厂计划。根据美光官网数据显示,计划到2035年,将总计在美国投入超过2500亿美元。

参考来源: 钛媒体
eMudhra quit the CA business today. I checked your trust store — its roots are still in it. 配图

eMudhra quit the CA business today. I checked your trust store — its roots are still in it.

核心内容
这篇文章主要探讨了印度认证机构eMudhra在发现其CA私钥被泄露后,决定退出全球SSL/TLS证书业务的决策过程。文章深入分析了eMudhra的声明,并检查了其信任存储、Mozilla的吊销列表和事件记录,以确定这一决策对全球网络安全的影响。
为什么重要
这篇文章的重要性在于它揭示了网络安全领域中认证机构面临的安全挑战,以及它们在应对这些问题时的决策过程。文章强调了eMudhra事件对全球SSL/TLS证书业务和用户信任的影响,并引发了关于网络安全的更广泛讨论。
关键洞察
最关键的洞察是,尽管eMudhra宣布退出全球SSL/TLS证书业务,但其根证书仍然存在于用户的信任存储中。此外,Mozilla的吊销列表已经将六个受影响的TLS中间证书进行了屏蔽。这表明,虽然认证机构可能退出市场,但他们的根证书仍可能继续影响网络信任环境。
潜在影响
受影响的是全球所有使用eMudhra证书的用户,他们可能会面临证书吊销和网站信任问题。此外,这次事件可能促使认证机构和网络服务提供商加强安全措施,以防止未来类似的安全事件发生。

Two days ago I wrote up the eMudhra incident: eight of the CA's intermediate private keys turned out to be integers smaller than 256 — I recovered all eight in 11 milliseconds, the largest was 237. Today eMudhra announced it is leaving the global SSL/TLS certificate business entirely (press release, Bengaluru, October 22; 894 points on Hacker News). A CA whose keys fit in a uint8 has decided certificates aren't worth it. Fair enough. But "a CA exits the business" is a press-release sentence, not a technical event — so I checked the three places where an exit would actually have to happen: your trust store, Mozilla's revocation list, and the incident record.

展开全文收起全文剩余 15 段 · 约 12 分钟

First, what the company says, in its own release: it revoked the affected CAs within 14 hours of discovery; no end-entity certificates were issued from the affected CAs; its infrastructure was not compromised and no data was breached. Global SSL/TLS is "about 1% of the global revenue," compliance costs are rising, big competitors give certificates away free, and "the level of social media amplification around this incident has brought scrutiny that is out of proportion to SSL/TLS's place in our business." The G1 RSA roots "will continue to serve customers until this transition is complete," customers get free replacements through partners, revocation and status services keep running until every issued certificate expires or is replaced, and a full root-cause report to the browser root programs is still owed.

Now the probes, all run today.

Your trust store: nothing has changed

``` /etc/ssl/certs/ca-certificates.crt (Ubuntu bundle, ca-certificates 20260816) 121 root certificates total still present: emSign ECC Root CA - C3 (O = eMudhra Inc) emSign Root CA - C1 (O = eMudhra Inc) emSign Root CA - G1 (O = eMudhra Technologies Limited) ```

Exit announced; roots still trusted. That is by design — the release says the G1 roots keep serving through the transition, and pulling a root before customers migrate is how you break other people's websites — but it means the practical state of the web PKI tonight is identical to the state on Monday, when the keys were already public knowledge. Distrust is a process with a mailing list, not an event.

Mozilla's revocation list: the six TLS intermediates are blocked by key

OneCRL, Mozilla's pushed revocation list, is not greppable as-is — issuer and subject names are base64'd DER, so a text search for "emSign" finds nothing and means nothing. Decoding every record's fields:

``` OneCRL records fetched live today: 1,907 entries whose SUBJECT is an eMudhra intermediate: 6 EM DV TLS CA - G3B EM OV TLS CA - G3B EM EV TLS CA - G3B EM DV TLS CA - G3C EM OV TLS CA - G3C EM EV TLS CA - G3C plus 20 issuer+serial entries for certificates issued under emSign roots ```

The six by-subject entries are exactly the six compromised TLS intermediates from the disclosure, blocked by public key — Firefox will reject anything chaining to those keys regardless of which certificate presents them. The two compromised code-signing intermediates (OV CS G3B/G3C) are not in OneCRL, because OneCRL is a TLS mechanism; code-signing trust runs through different stores. The 20 issuer+serial entries are individual revoked certificates under emSign roots — OneCRL accumulates those over years, so I'm not attributing all 20 to this incident; the six key-blocked intermediates are the incident's fingerprint.

The incident record: still open

Mozilla's Bugzilla 2083449, "eMudhra: Private key compromise of Intermediate Certificates," opened October 18, is still in status ASSIGNED — and it was last touched today, 2026-10-22 21:39 UTC, hours after the exit announcement. The root-cause report the press release promises to the root programs lands in processes like this one. Until it does, the public record still doesn't fully explain how a key ceremony produced eight production intermediate keys that a first-year cryptography student could enumerate — the working account, from the incident discussion, is that a wrap/unwrap test generated a second, weak key pair with a similar label and the wrong one went into the CSR.

The arithmetic of quitting

Strip the adjectives and the release is a math problem. For most CAs, SSL/TLS is the whole business; for eMudhra it was ~1% of revenue, carrying 100% of the reputational blast radius of running a publicly trusted CA — annual audits, CT logging, incident disclosure timelines measured in hours, and strangers on the internet (me) factoring your keys as a morning exercise. Every CA operator runs this calculation; eMudhra is just the one that ran it after the numerator went to zero in public. The rational move, and also the end of the story: the keys were recovered in 11 milliseconds, the business case took four days.

If you actually hold an emSign-issued certificate: per the release, the company will contact affected customers, replacements through partners are free, and status services stay up until your certificate expires or is replaced. Your root stays trusted in the meantime — I verified that part myself, above, which is more than I can say for most press releases.

Sources: eMudhra's press release (October 22, 2026); Mozilla Bugzilla 2083449 via its REST API; OneCRL records from firefox.settings.services.mozilla.com, decoded and counted locally today. My earlier key recovery: "Eight CA private keys were integers under 256. I recovered all eight in 11 milliseconds" (dev.to, October 20).

参考来源: DEV Community
为什么说奇瑞是一家AI公司? 配图

为什么说奇瑞是一家AI公司?

核心内容
文章主要讲述了奇瑞汽车通过应用人工智能技术,重新定义了自己造车的方式,将其转变为一家高科技创新企业,而非传统意义上的汽车制造商。
为什么重要
这个内容值得关注,因为它揭示了汽车行业正在经历的技术变革,以及人工智能在汽车制造和功能中的应用正日益加深,反映了汽车行业向智能化、自动化转型的趋势。
关键洞察
最有价值的观点是,奇瑞通过AI技术将造车方式重塑,将其能力转化为可复用的技术底座,并创造出汽车之外的新物种,表明AI技术已经成为推动奇瑞创新和发展的核心驱动力。
潜在影响
谁会受影响:消费者、投资者、竞争对手以及整个汽车行业。可能产生的变化:消费者将享受到更加智能化、个性化的汽车产品;投资者可能重新评估汽车行业的投资价值;竞争对手可能加速向智能化转型;整个汽车行业可能会加速向智能化、数据驱动的方向发展。

您正在使用IE低版浏览器,为了您的雷峰网账号安全和更好的产品体验,强烈建议使用更快更安全的浏览器

此为临时链接,仅用于文章预览,将在时失效

展开全文收起全文剩余 84 段 · 约 10 分钟

智能驾驶 正文

发私信给王瑞昊

发送

导语:奇瑞为什么是AI公司?它用AI重造了自己造车的方式,把这层能力做成可复用的底座,并让它长出了汽车之外的新物种。

奇瑞为什么是AI公司?它用AI重造了自己造车的方式,把这层能力做成可复用的底座,并让它长出了汽车之外的新物种。

作者 | 王瑞昊

编辑 | 李雨晨

“有几位领导跟我说,感觉奇瑞的汽车越来越不像汽车了,奇瑞也越来越不像一家车企了。这是我想听到的——奇瑞就是一家「披着汽车企业马甲」的高科技创新企业。”

10月20日,2026奇瑞全球创新大会在安徽芜湖开幕。说出这句话的,是做了四十多年汽车的奇瑞汽车董事长尹同跃。一个把大半辈子交给汽车的人,主动摘掉“车企”这块招牌,不是自谦,是判断。

他的依据是一个隐喻:1886年,奔驰造出第一台汽车,被时代抛下的,是那些一辈子赶马车的养马人,他们没做错什么,只是没看见路已经变了。“真正的风险不是AI太强太快,而是我们不能继续做当年的养马人。”尹同跃说,“未来AI真正淘汰的,是拒绝AI、不敢用AI的企业。”

所以奇瑞的选择很直白:刀口向内,主动用AI给自己做一场基因重组,先改变自己,再改变世界。

雷峰网(公众号:雷峰网)认为,判断奇瑞是不是AI公司,不能看它发布会上喊了多少次AI,要看三件事:AI有没有重构它的生产流程,有没有沉淀为可复用的统一底座,有没有在汽车之外长出新的物种。

PART 1

从CheryMind到紫微芯片

奇瑞把30年造车经验炼成了AI底座

市面上的通用大模型像一本百科全书,什么都能聊,但一进工厂车间就不够用了,精度不够、深度不够、可靠性不够。奇瑞的选择是自研垂类基础大模型CheryMind,该模型具备三大特征:懂物理世界的大脑、与业务共进化、全域可落地。

支撑它的不是爬来的互联网语料,而是奇瑞近30年攒下的家底:700TB企业知识,覆盖技术标准、工艺规范、设计准则、安全规范;200PB工程数据,从仿真结果到试验数据、从CAD到实车全链路;千万级研发文档;2500万条教练级驾驶数据;500万条机器人动捕数据。

物理AI时代的壁垒,不是数据有多少,而是数据从哪来。通用大模型爬的是互联网,CheryMind吃的是30年造车沉淀下来的技术标准、工艺规范、仿真与试验数据。这是别人买不到、也爬不走的教材。

雷峰网了解到,而且它已经在跑,不是PPT:端到端业务流程1500+,企业系统打通400+,员工每日使用6万+,覆盖业务场景200+。奇瑞汽车执行副总裁、CTO高新华在现场给了一组对比:以前一名工程师做一轮仿真优化,要跑6轮、花上百天;现在基于CheryMind,每人100个方案半天出结果,效率提升42倍。

CheryMind分两条腿走路。企业端垂模让AI更懂造车:CAD垂模、质量垂模、制造垂模、企业Agent垂模,覆盖研发—制造—质量—供应—营销—运营全链条;产品端垂模让汽车更懂人和物理世界:智舱、智驾、车端智能、飞控垂模、MoAgent、农机OS,一路延伸到eVTOL、机器人和农机。

关键在闭环,垂模在真实场景里形成的新能力,持续回流基座模型。业务和产品两大引擎互相喂养,CheryMind越用越强。自我进化,是判断是否为AI公司最硬的一条标准——工具不会自我进化,底座才会。

CheryMind之外,奇瑞发布了自研芯片,命名取自紫微星——北极星,众星环绕,指引方向。紫微芯片三大系列,各管一件事。

C系列管思考。中央计算芯片C100,整车NPU算力2400TOPS,内存带宽600GB/s,支持100B大模型端侧部署,80ms跑完从感知到决策的E2E算法闭环——不到人眨一次眼的时间。对标行业旗舰,带宽2.2倍、算力1.2倍、图像处理1.5倍。

S系列管能量。车规级碳化硅S1500,耐压1500V,行业最高;出流1450A,效率≥99.6%,结温200℃,8英寸晶圆量产成本下降30%以上。

M系列管控制。车规控制芯片,MC200域控、MS100预驱、MX100 PMIC、MC100电驱,从2027年起依次落地。

这三件事背后是奇瑞过去五年的账:研发投入超1100亿元,313个瑶光实验室,智驾渗透率两年提升267%。AI改写的是造车本身的成本曲线,不是营销话术。

更值得注意的是一层协同:大模型定义芯片该长什么样,100B端侧部署倒逼2400TOPS算力和600GB/s带宽;芯片反过来决定模型能落多深。这种“模型—芯片”协同定义,是科技公司而非集成商的特征。

尹同跃有句话放在这里很合适:奇瑞“对技术贪得无厌,对安全胆小如鼠”。AI能替代技能,但替代不了人性、责任与温度。

PART 2

一个底座 长出四种自由

AWE 猎鹰 灵犀 Robotaxi和机器人

这场大会真正发布的不是单一技术。尹同跃的总结是:出行、能源、粮食、生活不是四个孤立的方向,它们共享模型、芯片、数据和工程能力,又在真实场景里不断产生新需求。结构是“一个底座×N个场景”。

底座先用在最难的场景:智驾出海。东南亚两轮车和汽车共用车道、暗光路口逆行、强行加塞……中国市场跑通的方案,拿到海外未必成立。

奇瑞的判断是:全球化竞争中该比拼的不是算力、数据或激光雷达数量,而是模型底座。没有统一底座,每进一个新市场、每上一款新车就要重做一套方案。

奇瑞全维世界引擎(CHERY AWE)用三个模型接住这件事。

构境模型负责“看懂世界”:已构建70万+场景,其中高危30万+、极限2万+,把多视角图像、LiDAR点云、场景结构、描述文本和行车轨迹五类数据统一编码进隐空间,支撑长尾场景闭环仿真;观语模型负责“读懂语义”:多模态推理加短期记忆和语言拓扑图,像老司机一样仅凭路标到达目的地,输出可追溯的推理链;行策模型负责“做出行为”:MoT多专家架构,从“被动应对危险”转向“主动预判风险”。

猎鹰辅助驾驶系统已经带着这套底座跑了一年:满足130多个国家和地区的法规准入,拿下C-ICAP五星+、IVISTA G+认证,中国智驾大赛六连冠。

猎鹰智驾分三个版本:猎鹰500入门即城区、油电同智;猎鹰700全场景车位到车位、跨层代客泊车;猎鹰900覆盖高速和城区L3,感知、控制、电源全冗余。

座舱端,灵犀8D智感座舱用AIOS全域架构打通底盘、座舱、车身、智驾、动力五域,整车级信号协同编排、毫秒级跨域响应。舱外识别行人意图,舱内感知情绪疲劳,从“人找功能”升级为“功能找人”;听觉、视觉、嗅觉、动感、触觉、情感、健康、社交八维统一编排,一句话Skill自由编排,千人千面。伯牙之音33扬声器、43.7英寸PHUD、S2S端到端语音这些细节,都在往“车更懂人”的方向堆。

行业首款为全球而生的原生前装Robotaxi,五大原生——架构、前装、体验、运营、全球化,六层安全——乘客、行为、感知、算法、执行、车队,目标2030年10万辆全球运营。

机器人则是车机同源:30年汽车供应链、硬件架构、质量体系直接复用,六大领域布局31个创新应用实验室。Multi-agent智能架构下,基于CheryMind研发的MoAgent 2.0用慢大脑理解规划、快大脑实时响应,端边云协同形成“执行—反馈—优化—再执行”的数据闭环。

产品矩阵已经铺开:四足/轮足机器狗、智警、导医、墨宝家庭陪伴、工业及人形机器人;墨甲机器人现已出海2000+台,覆盖60多个国家。

此外,在能源自由和粮食自由方面,迅龙秒充充电5分钟续航500公里,固态电池中试线2027年上半年投用;智慧农机能耗下降74%,同一块地亩产从1600斤提到2000斤,目标是2035年服务全球10亿亩农田。

这些场景放在一起,奇瑞做AI最独特的杠杆才显出来:复用率就是AI时代的毛利率。同一套模型、芯片、供应链在汽车、Robotaxi、机器人、农机之间迁移,边际成本递减。这是制造业出身的公司做AI才有的优势。

奇瑞也清楚单靠自己跑不完所有场景。它正从产品制造者走向生态组织者:向供应商、高校、创业者开放技术平台、场景与产业化能力,与中科大共建2050未来学院,做长周期、可容错的前沿探索。

所以奇瑞为什么是AI公司?因为它用AI重造了自己造车的方式,把这层能力做成可复用的底座,并让它长出了汽车之外的新物种。

用尹同跃的话说:“技术只有走出实验室,进入道路、家庭、农田与能源系统,持续解决真实的问题,才能真正创造自由。”

三十岁的奇瑞不想再做一家汽车公司。这话听起来像口号,但当一家车企的机器人开始真正解决社会痛点,它的模型开始决定自己的芯片长什么样时,它就不再只是一句口号了。

奇瑞新战事:出海、智驾、与比亚迪们的正面交锋

比奔驰S还大,大汉 EV能否撑起比亚迪的冲高野心?

雷峰网原创文章,未经授权禁止转载。详情见转载须知。

0人收藏

分享:

相关文章

新智驾独家丨奇瑞高层人事调整:智能化中心负责人谢 ...

还有市场吗?苹果与LG联合开发门铃门锁等;DeepSeek ...

7月车市销量解读:比亚迪一骑绝尘,零跑首破10万,奇 ...

奇瑞携12款产品亮相成都车展:风云T7即将上市,艾瑞 ...

王瑞昊

编辑

发私信

当月热门文章

零跑朱江明放话第二品牌要做iPhone式产品革命,哪来的自信?

吉利银河战舰700上市:限时焕新价16.98万元起,押注电混与智能越野

独家丨舒酉星创立新公司「星能远行」,此前是比亚迪欧洲总裁

45分钟小定8000台,智己LS6这次成了?

独家丨蔚来李斌最新内部讲话:明年将有重量级新车,未来3年的核心是三个聚焦

最新文章

当车企抢着自研电池,智己为什么反着来?

10-50万级全覆盖,千里智驾量产进入放量期

12.88万起、华为电驱+L4同源智驾,Ray7能成为埃安年轻化的答卷吗?

吉利银河战舰700上市:限时焕新价16.98万元起,押注电混与智能越野

费莫一刘念邱:智驾无图的经验,也能迁移到机器人 | 物理AI 50人

解读丨全系上自研电池,理想要干什么?

热门搜索

机器人 HTC 创业 计算机视觉 联发科 AlphaGo 隐私 看点 地图 iPhone 5C 风控

为了您的账户安全,请验证邮箱

您的邮箱还未验证,完成可获20积分哟!

重发邮箱修改邮箱

请验证您的邮箱

立即验证

完善账号信息

您的账号已经绑定,现在您可以设置密码以方便用邮箱登录

立即设置 以后再说

参考来源: 雷锋网
TinyFish Makes Search Free: What It Really Costs an AI Agent to Read the Web 配图

TinyFish Makes Search Free: What It Really Costs an AI Agent to Read the Web

核心内容
文章主要讲述了TinyFish,一家为AI代理提供网络基础设施的公司,如何通过其Web原生AI模型,免费提供搜索服务,并分析了AI代理在读取网页时产生的两种成本:检索费用和模型处理费用。
为什么重要
这个内容值得关注,因为它揭示了AI代理在读取网页时的成本结构,并指出企业在预算模型时往往会低估检索内容的重要性。此外,TinyFish的免费搜索服务可能会改变AI代理市场的竞争格局。
关键洞察
最有价值的观点是TinyFish的Web原生AI模型不仅能够提供免费检索服务,而且在其性能指标上也处于领先地位。另一个关键洞察是,检索费用通常被企业忽视,但它对模型处理费用有着直接影响。
潜在影响
TinyFish的免费搜索服务可能会影响AI代理提供商的定价策略和市场定位。企业可能会更加倾向于使用TinyFish的服务,因为它们可以节省检索费用,并且TinyFish在性能上具有竞争力。这可能会导致市场出现更多基于性能的竞争,而不是单纯的成本竞争。

An AI agent that reads the web pays 2 kinds of cost. The first is the retrieval charge: what a search or fetch API bills per request. The second is model processing: content passed from retrieved pages into an AI model consumes tokens, while reasoning and generated responses add further costs. TinyFish, a web infrastructure company for AI agents, argues that teams budget for the model and underestimate how much retrieved content drives it.

展开全文收起全文剩余 18 段 · 约 13 分钟

This article walks through the token math, the context-window impact, and what the Artificial Analysis Search API leaderboard does and does not show.

**TL;DR**

**What it runs on:** TinyFish uses a web-native AI model designed for search, retrieval, and interaction with live websites. The model runs on TinyFish-managed infrastructure, while its cloud browser fleet renders pages and handles website interactions. No local GPU is needed. Access is via REST, Python and TypeScript SDKs, CLI or MCP.

**Performance:** On the Sep 28, 2026 Artificial Analysis snapshot, TinyFish Search (web) scores 71 at $9.30 per 1,000 benchmark tasks, with 59.0 seconds per task (model plus search time).

**Best:** $0 retrieval charge within rate limits (Search: 30 requests/min, 500/hour; Fetch: 150 URLs/min, 1,000/day), and the lowest total cost among the 12 configurations displayed on the leaderboard.

**Trade-offs:** The second longest time per task among displayed configurations, and an Agent product whose built-in model cannot be swapped.

**Scores:** Highest displayed is Perplexity Search (medium) at 80. Lowest displayed is TinyFish Search (web) at 71. The no-search baseline is 33.

Search and fetch APIs usually bill per request or per page. Whatever they return then enters the model’s context and is billed as input tokens. Reasoning and output tokens come on top. Enterprises now route each task to the cheapest capable model, a trend underlined when Stripe agreed to acquire OpenRouter, a gateway spanning 400+ models from 80+ providers. Routing lowers the price per token. It does not change how many tokens a retrieved page contains.

Free Search and Fetch remove TinyFish’s retrieval charge within its limits. The downstream model still incurs inference costs. That is why the size of each returned page matters.

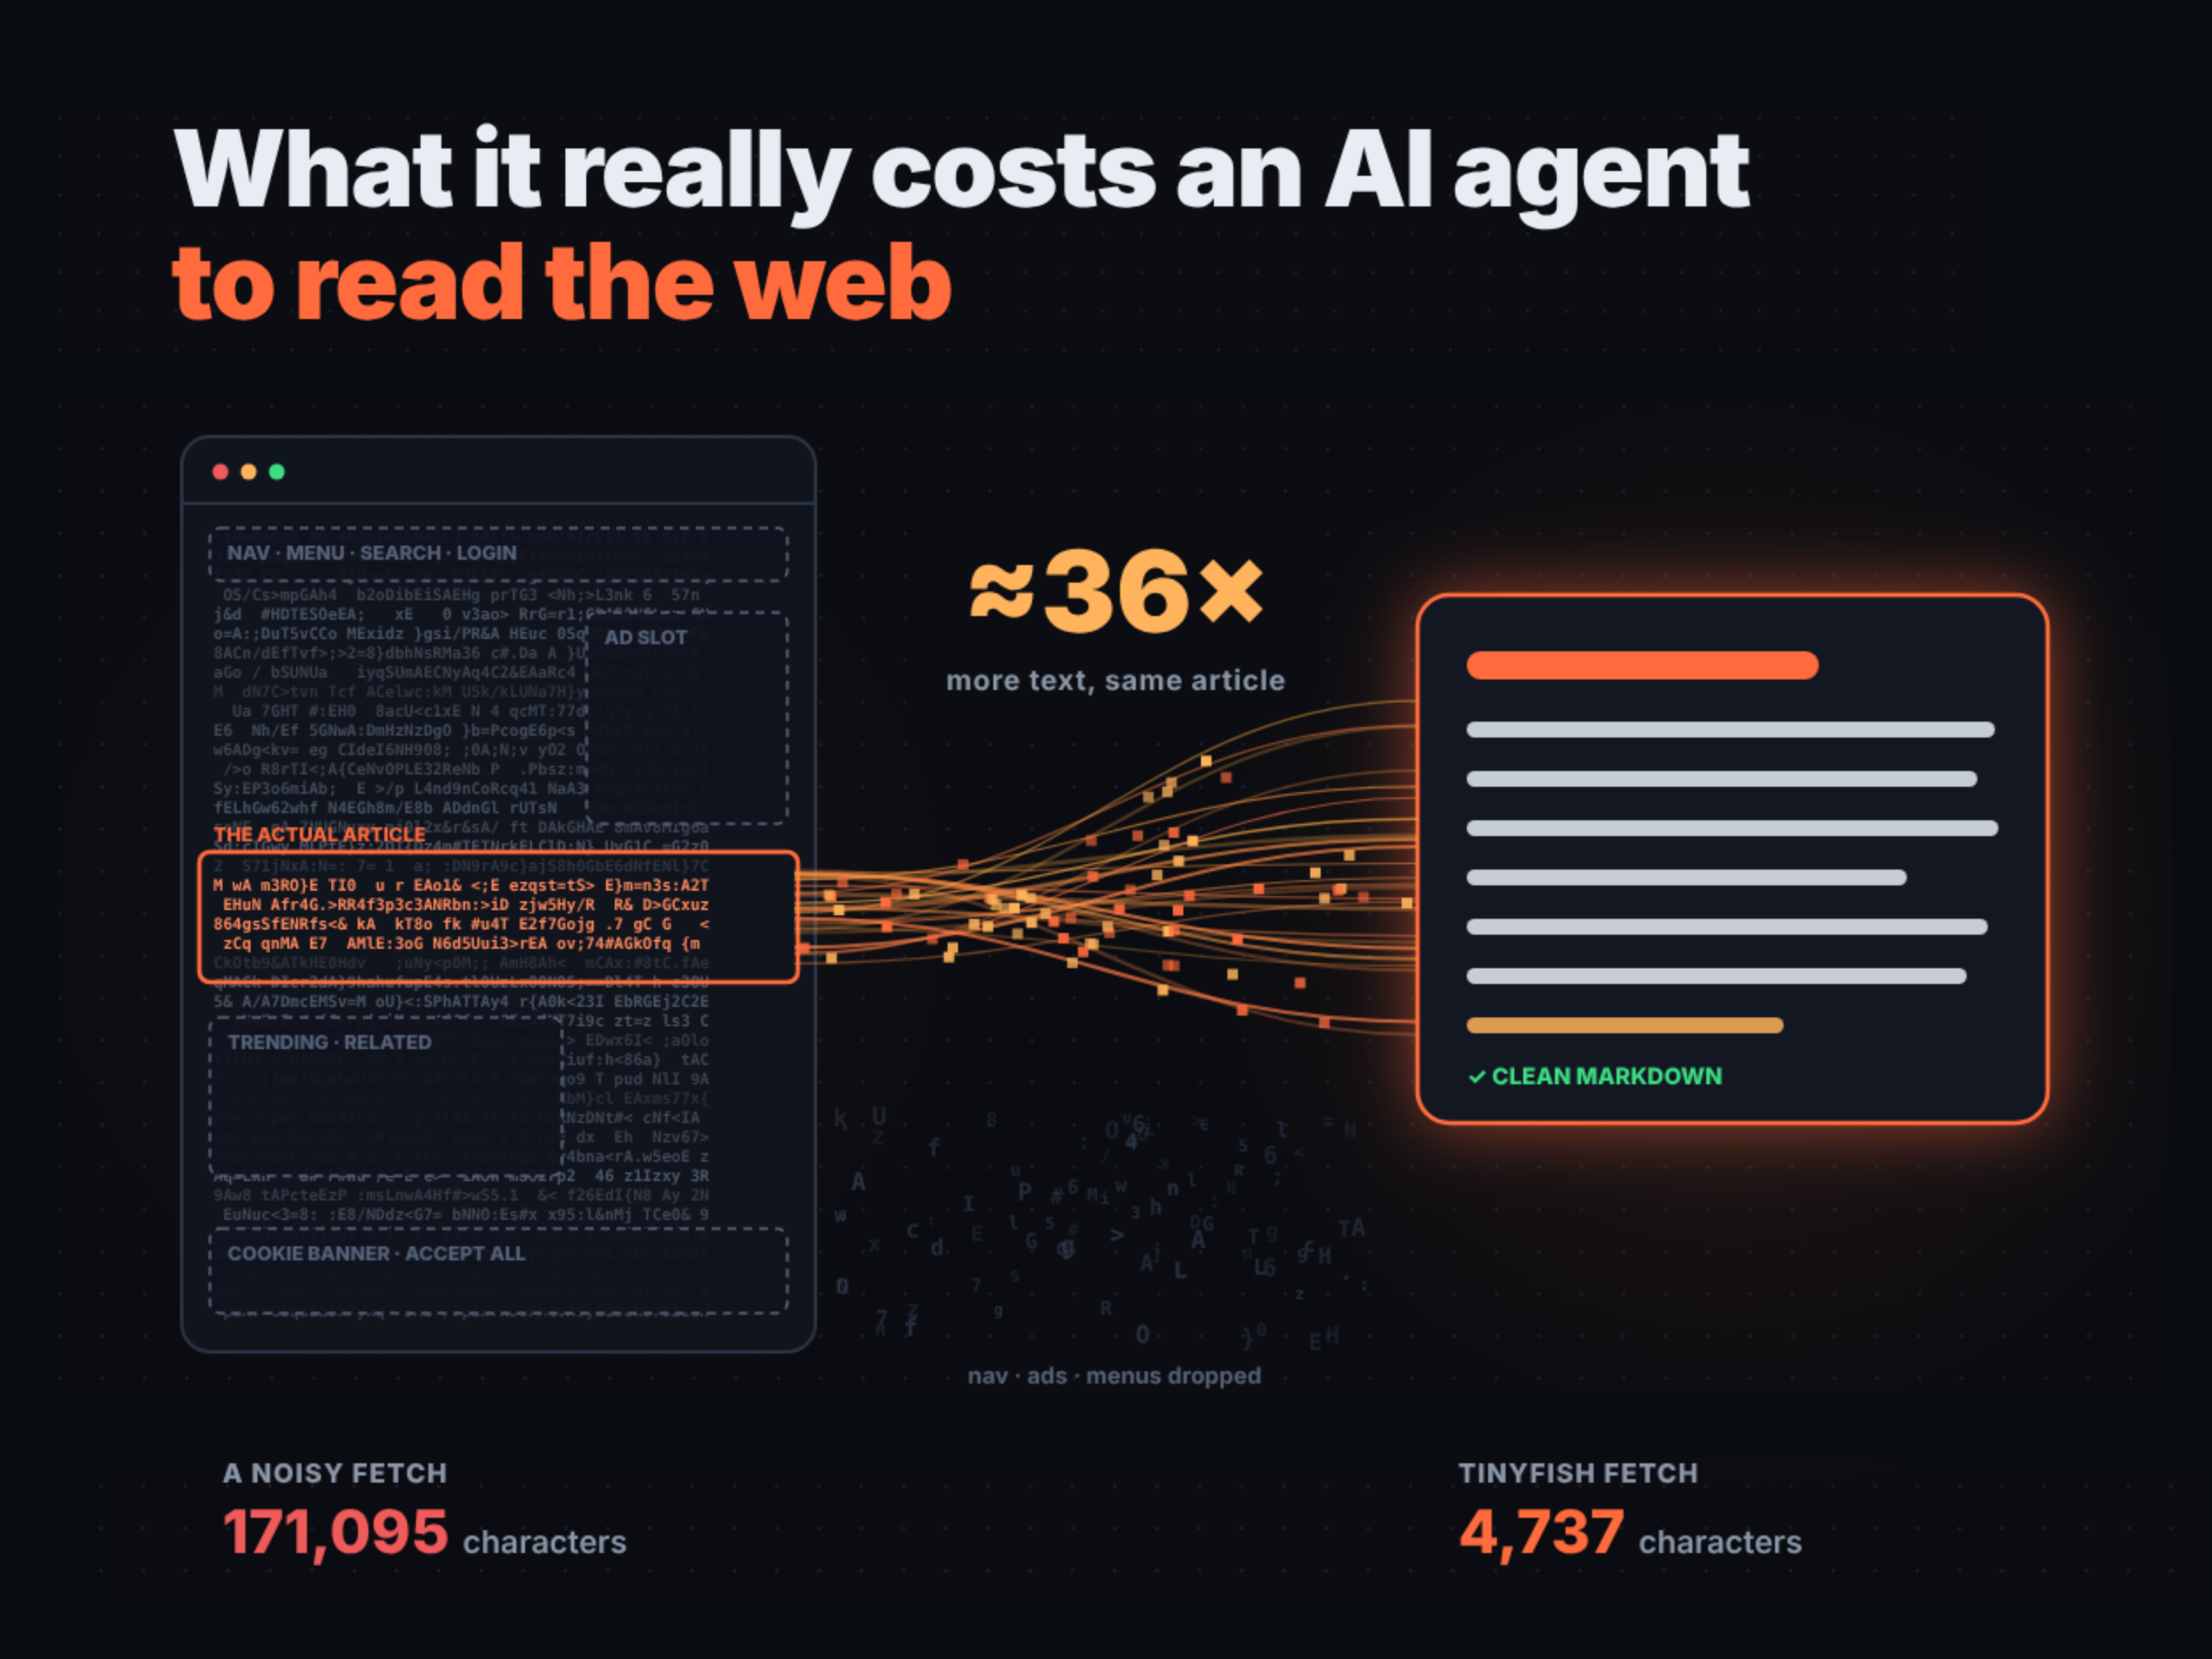
TinyFish ran a fetch quality evaluation on June 2, 2026, across 45 URLs and 5 providers on default settings. For one Daily Mail article with a body of roughly 4,300 characters, the providers returned:

* Firecrawl returned approximately 36 times as many characters as TinyFish. * Parallel also returned only an excerpt rather than the complete article, so its smaller output is not directly comparable to the full-page extractions.

While this illustrates how extraction output size can affect token consumption, the difference comes from a single webpage and should not be generalized across all websites. Those percentages are not used for this individual page comparison because outputs above 30,000 characters were truncated before judging.

Assume every extracted character goes into the same context, with no filtering, truncation or summarization. A page containing approximately 42,774 tokens would consume about one-third of a 128K-token context window. Three such pages would require approximately 128,322 tokens, leaving little or no room for system instructions, conversation history, or the agent’s response.

Agent loops also resend context. Artificial Analysis notes that each turn resends the full conversation, with earlier input billed at the model’s cached-input price. Caching lowers the cost of rereading a noisy page. It does not remove it, and the page still occupies the window.

In that TinyFish internal evaluation, a result counted as covered only with at least 1,000 characters and a judged signal ratio above 30%. Coverage was TinyFish 93%, Tavily 80%, Exa 73%, Firecrawl 62% and Parallel 58%. Among usable results only, median signal was 90.5% for TinyFish and 89.7% for Exa. TinyFish ran the test on itself, the sample is 45 URLs, and news pages drove most of the gap.

TinyFish frames search as one operation inside execution, like DNS or storage for ordinary software. An agent booking, comparing or filling out a form should care whether the job got done, not which search system found the page. TinyFish attributes its free retrieval pricing to three aspects of its infrastructure:

* **Shared infrastructure:** TinyFish built its browser fleet, stealth systems, session hydration and elastic scaling before Search was a product. TinyFish says this changes the marginal economics of search. It does not make the infrastructure free to run. * **Specialized models:** TinyFish says its web-native AI model is designed for search, fetch, and live-site interaction. Its development draws on agent operational trajectories and large volumes of search activity, helping reduce reliance on general-purpose models for intermediate web tasks. * **No giant index:** TinyFish says it would rather learn how work gets done than become an indexing company.

TinyFish charges separately for Agent and Browser usage, while Search and Fetch remain free within their published limits. Per the pricing page, Search is free at 30 requests per minute and 500 per hour. Fetch is free at 150 URLs per minute and 1,000 per day. Both keep working at a $0 Wallet balance. Agent costs $0.016 per step with 2 concurrent runs, and Browser costs $0.002 per minute with 5 sessions. New accounts get $8 in Wallet funds.

参考来源: MarkTechPost

Physical AI: Concepts, Techniques, and Challenges

核心内容
文章主要探讨了物理人工智能(Physical AI)的概念、技术及其面临的挑战。它详细阐述了物理AI的定义、技术框架、关键子领域,并对比了物理AI与传统的数字AI、具身AI、网络物理系统和数字孪生等概念。文章还回顾了物理AI的关键方法论,并探讨了其在机器人、制造、基础设施、科学实验和自主服务等方面的应用。
为什么重要
物理AI作为人工智能领域的一个新兴方向,其重要性体现在它能够使人工智能系统更好地感知、建模和作用于物理世界。这一领域的发展不仅有助于推动人工智能技术的进步,而且对工业自动化、智能制造、智能交通等领域的发展具有重要意义。文章的发表有助于学术界和工业界对物理AI有一个全面和深入的了解,从而推动相关研究和应用的快速发展。
关键洞察
文章的最有价值观点是提出了物理AI的统一框架,即通过连续反馈在现实世界约束下感知、建模和作用于物理世界的系统。此外,文章还强调了物理AI与数字AI、具身AI等概念的区分,以及物理AI在物理学、控制、认知、学习和推理等方面的基础研究。文章还指出了物理AI在模拟到现实迁移、可靠性、实时执行、评估、安全、治理和长期部署等方面面临的挑战。
潜在影响
物理AI的发展将对多个领域产生深远影响。它将推动机器人、制造、基础设施等行业的智能化升级,提高生产效率和质量。同时,物理AI也将促进人工智能技术与其他学科的交叉融合,为解决复杂问题提供新的思路和方法。此外,物理AI的长期发展可能引发对人工智能伦理、安全和社会影响的广泛讨论。

Skip to main content · Press Enter to search · Advanced search · Computer Science > Artificial Intelligence · arXiv:2610.27045 (cs) · [Submitted on 19 Oct 2026] · Title:Physical AI: Concepts, Techniques, and Challenges

展开全文收起全文剩余 79 段 · 约 12 分钟

Authors:Weinan Zhang, Chunhua Shen, Tianfan Xue, Bin Zhao, Bingqi Jiang, Zihan Guo, Zicai Cui, Yang Li, Ming Zhou, Xinyuan Chen, Lihe Ding, Xiao Chen, Yujin Wang, Shi Guo, Junting Dong, Tao Lu, Xing Shen, Haoyu Guo, Yao Mu, Haiyong Yu, Haoxiang Ma, Fuxian Huang, Qiaojun Yu, Yunsong Zhou, Kailin Li, Zirui Wang, Yufei Xue, Weishuai Zeng, Tao Huang, Zhigang Wang, Junli Liu, Pengyuan Wu, Pingrui Zhang, Haotian Wang, Dongzhan Zhou, Jiafei Cao, Feng Yuan, Xinyi Ye, Quanli Xuan, Mulin Yu, Shangding Gu, Kaiwen Song, Dong Wang, Jiarui Li, Kehui Liu, Zhongjie Jia, Dongjiang Li, Jiacheng Bao, Haoran Yang, Zhaoqing Chen, Yiming Sun, Bowen Zhou

View a PDF of the paper titled Physical AI: Concepts, Techniques, and Challenges, by Weinan Zhang and 51 other authors

View PDF HTML (experimental)

Abstract:In recent years, physical artificial intelligence (physical AI) has experienced rapid development, capturing significant attention in academia and industry. However, the field has yet to reach consensus on its definition, technical landscape, and core challenges. To address this gap, this monograph seeks to define physical AI, present its technical landscape, and examine each key technical subfield in depth. In doing so, it establishes a unified framework for Physical AI: artificial systems that perceive, model, and act upon the physical world through continuous feedback under real-world constraints. Further, this monograph distinguishes physical AI from conventional digital AI, embodied AI, cyber-physical systems, and digital twins. It develops the foundations of physical AI across physics, control, cognition, learning, and reasoning. It reviews key methodologies, including multimodal perception, physical data and simulation, world models, embodied foundation models, motor-control systems, multi-agent coordination, and hardware-software co-design. Furthermore, it examines applications spanning robotics, manufacturing, infrastructure, scientific experimentation, and autonomous services. Particular attention is given to sim-to-real transfer, reliability, real-time execution, evaluation, safety, governance, and long-term deployment. By connecting perception, prediction, decision-making, action, and adaptation in a closed loop, this monograph identifies the technical challenges and research directions required to advance from narrow automation toward more generalizable physical AI and, ultimately, physical artificial general intelligence (Physical AGI).

Submission history

From: Weinan Zhang [view email]

[v1] Mon, 19 Oct 2026 17:50:11 UTC (22,937 KB)

Full-text links:

Access Paper:

View a PDF of the paper titled Physical AI: Concepts, Techniques, and Challenges, by Weinan Zhang and 51 other authors

View PDF

HTML (experimental)

TeX Source

view license

Additional Features

Audio Summary

Current browse context:

cs.AI

< prev | next >

new | recent | 2026-10

Change to browse by:

cs

cs.RO

References & Citations

SciX

Google Scholar

Semantic Scholar

Loading...

BibTeX formatted citation

loading...

Data provided by:

Bookmark

Bibliographic Tools

Bibliographic and Citation Tools

Bibliographic Explorer Toggle

Bibliographic Explorer (What is the Explorer?)

Connected Papers Toggle

Connected Papers (What is Connected Papers?)

Litmaps Toggle

Litmaps (What is Litmaps?)

scite.ai Toggle

scite Smart Citations (What are Smart Citations?)

Code, Data, Media

Code, Data and Media Associated with this Article

alphaXiv Toggle

alphaXiv (What is alphaXiv?)

Links to Code Toggle

CatalyzeX Code Finder for Papers (What is CatalyzeX?)

DagsHub Toggle

DagsHub (What is DagsHub?)

GotitPub Toggle

Gotit.pub (What is GotitPub?)

Huggingface Toggle

Hugging Face (What is Huggingface?)

ScienceCast Toggle

ScienceCast (What is ScienceCast?)

Demos

Replicate Toggle

Replicate (What is Replicate?)

Spaces Toggle

Hugging Face Spaces (What is Spaces?)

Spaces Toggle

TXYZ.AI (What is TXYZ.AI?)

Related Papers

Recommenders and Search Tools

Link to Influence Flower

Influence Flower (What are Influence Flowers?)

Core recommender toggle

CORE Recommender (What is CORE?)

Author

Venue

Institution

Topic

About arXivLabs

arXivLabs: experimental projects with community collaborators

arXivLabs is a framework that allows collaborators to develop and share new arXiv features directly on our website.

Both individuals and organizations that work with arXivLabs have embraced and accepted our values of openness, community, excellence, and user data privacy. arXiv is committed to these values and only works with partners that adhere to them.

Have an idea for a project that will add value for arXiv's community? Learn more about arXivLabs.

Which authors of this paper are endorsers? | Disable MathJax (What is MathJax?)

参考来源: ArXiv AI
Anthropic几乎停招初级员工!占比一年半骤降33%:Agent工时已是员工6倍 配图

Anthropic几乎停招初级员工!占比一年半骤降33%:Agent工时已是员工6倍

核心内容
文章主要讲述了人工智能公司Anthropic在技术团队中初级员工占比骤降,AI Agent工作时长快速增长的现象,以及这一变化对公司招聘、工程基础设施和组织结构的影响。
为什么重要
这个内容值得关注,因为它反映了AI技术发展对传统工作模式的影响,以及AI在提高工作效率和改变工作性质方面的作用。这同时也反映了AI技术发展可能带来的就业结构变化和社会影响。
关键洞察
最有价值的观点是,AI Agent的崛起正在替代初级工程师的部分工作,如编写代码和查找Bug,导致初级工程师的需求减少。同时,AI Agent也改变了工程组织的协作结构,使得管理与协调岗位需要亲自参与代码交付,而监督他人编写代码的岗位价值下降。
潜在影响
这种变化可能会影响初级工程师的就业市场,减少初级工程师的就业机会。同时,它也可能促使教育体系调整课程,以适应AI技术发展对人才需求的变化。此外,这种变化还可能促使企业重新考虑如何利用AI技术提高效率,以及如何重新设计工作流程和组织结构。

Anthropic 几乎停招初级员工!占比一年半骤降 33%:Agent 工时已是员工 6 倍 · Tina · 2026-10-21 · 北京 · 本文字数:3627 字 · 阅读完需:约 12 分钟

Anthropic 首席执行官 Dario Amodei 曾预测,到 2030 年,一半入门级白领工作可能消失。现在,Anthropic 自己公布的数据,已经显现在技术团队中:初级员工占比下降,AI Agent 的工作时长则快速增长。

展开全文收起全文剩余 43 段 · 约 10 分钟

Anthropic 的一项内部研究显示,自 2025 年初以来,技术部门初级员工占比从 21% 降至 14%,占比相对降幅约 33%;新招聘员工中的初级员工占比降幅更大,同期从 27% 降至仅 9%;自 2025 年 12 月以来,初级岗位的招聘信息减少得尤其明显。

AI 接手代码工作,初级招聘随之收缩

编写代码、查找 Bug 这些曾经是初级工程师“练手”的核心任务,如今越来越多地交给 Claude 处理。 截至 2026 年 8 月,公司整体 Agent 与人类的工作时长比达到 6:1,研究部门更是高达 19:1。Anthropic 把这一变化归因于 AI Agent 能力的跃升。

数据也印证了这种转移的规模:工程师提交的代码变更次数达到此前的 5.1 倍,数据科学家执行的查询达到 3.1 倍,法务团队处理的合同也达到 3.1 倍。一名员工在报告中直言,工程师生产效率的提升“一夜之间改变了我们对招聘人才的要求”。

代码交付速度加快,也推动了工程基础设施的改造。四个月内,Anthropic 的代码合并量增长了 12 倍,公司因此搭建了自己的内部版本控制系统,以适应持续扩大的工程工作量。

这种变化并非简单的“机器换人”。报告显示,技术部门中完全不直接编写代码的员工占比在过去一年几乎减半,管理者提交代码的频率几乎翻倍,工程师与产品经理的比例扩大到约 17:1。

换句话说,Agent 不仅替代了初级岗位的战术性工作,还在重塑整个工程组织的协作结构——管理与协调岗位被迫亲自交付代码,而“监督他人编写代码”这件事本身正在贬值。

图注:Claude 使用复杂度与初级岗位就业增长。

与此同时,技术部门的招聘绝对人数仍在增长,但其占全公司员工的比例过去一年从 61% 降至 56%。 销售、财务和招聘部门的增长速度更快,部分原因是编码 Agent 让非工程人员也能构建自己的工具。Anthropic 举例说,一位销售代表在没有任何用户界面设计经验的情况下,仅用了三四个小时就构建了一个集成了多种工具的自定义仪表板和流程。

非技术员工使用编程 Agent 的会话次数也大幅增加:从 2025 年 8 月每月约两次,升至 2026 年 5 月每月 90 次。这一采用速度与同期整个行业 Agent 编程工具的增长趋势一致。与此同时,一些公司出于安全考虑开始限制 AI Agent 的使用,亚马逊、摩根大通、嘉信理财和达美航空都在部分系统中封锁了 AI Agent。

Anthropic 称,公司已建立预警系统,用来识别可能受到冲击的岗位,并优先安排员工在内部转岗,而非裁员。2026 年,入职至少一年的员工每月转到其他部门的可能性,比 2025 年高出 50%。例如,一个过去负责撰写 Claude.ai 应用内文案的产品设计团队,后来搭建了一个“上下文图谱”,让 Agent 能自行撰写这些文案;随后,团队转而为 Claude 编写提示词和评测。

Anthropic 认为,鉴于公司已将 AI Agent 深度融入自身工作流程,其变化可能预示着行业发展方向。其他公司在采用类似工具后是否会出现相同的招聘模式,还有待观察。不过,Anthropic 自己的数据表明,不到两年时间,技术职业发展阶梯中的入门级岗位已经与过去大不相同。

本来就不招初级:资深人才占据主体

Anthropic 的工程团队本身就像一支由资深基础设施工程师组成的高速扩张军团。

招聘从业者 Sebastian Cuadros 基于 LinkedIn 公开资料做了一项分析:他抓取了 5306 名将 Anthropic 列为当前雇主的用户,从中筛选出 1680 名真正从事工程岗位的员工,并进一步分析了这些人加入 Anthropic 前留下的 7986 段过往岗位描述。结果与“前沿 AI 实验室”的常规想象存在明显偏差。

这是一支大约在 18 个月内搭起来的组织。目前仍在 Anthropic 的工程师中,只有 15 人在 2021 年之前就已入职。2025 年,工程团队规模扩大约三倍,当年招聘 686 名工程师;2026 年截至 6 月又招聘了 455 人。当前工程团队中有一半人任职不足一年,过去 12 个月加入的人占 53%,任职时间中位数只有 10 个月。

这组履历数据还说明,Anthropic 几乎不招初级工程师。这一倾向并非始于 Agent 的崛起——它的招聘门槛本来就设在资深一侧。1680 名工程师加入公司前的工作经验中位数为 12.2 年,中间 50% 的人拥有 8.8 年至 16.5 年经验;工作经验少于 3 年的只有 50 人,拥有 13 年及以上经验的人占比达到 44%。应届生招聘基本不存在。

一个典型的新招工程师画像是:拥有 12 年工作经验,但在公司只待了 10 个月。

极少数年轻工程师的进入方式,也依赖高强度筛选而非常规校招,主要靠其他高标准来补足工作年限:

第一类是实习管道。半数人拥有 Meta、Google、DeepMind、Microsoft、Amazon 等公司的实习经历,此外还有 Jane Street、Two Sigma、HRT、Optiver、Nvidia。

第二类是从量化交易转向实验室。9% 的人来自顶级交易公司,包括 Jane Street、Two Sigma、Five Rings、HRT、Optiver、Citadel。这些是年轻的数学、计算机竞赛型人才,通过高频交易行业进入 AI 实验室。

第三类是 AI 对齐奖学金。6% 的人接触过 MATS、SERI、Redwood 或 ARC。这是一条几乎只面向初级人才的入口,在资深工程师群体中几乎不存在。

这类年轻工程师的典型画像是:MIT 背景,国际信息学奥林匹克竞赛银牌,Codeforces 评分 2900+,工作四年左右后进入强化学习和 AI 安全方向。他们被筛选时看的是竞赛排名和论文,而不是工作年限。

资深人才占据主体,意味着这家公司当前的工程能力建立在一批“已经养成”的人身上;而入门级岗位的减少,意味着下一批这样的人从哪里来,暂时还没有答案。

认知公地的悲剧:省下的培养成本,未来由谁偿还

在一篇讨论 AI 与专业人才培养的论文中,研究者 Nolan Lovett 将这种风险称为“认知公地的悲剧”:企业用 AI 替代入门级工作,效率收益归自己;但如果整个行业都减少了培养新人的机会,未来需要资深人才时,专业能力的来源也会变少。

这笔账要过很多年才会到期:Lovett 指出,今天在岗的资深专业人士,大多是在 5 至 20 年前接受训练的。因此,从 2023 年开始出现的初级岗位收缩,其完整影响可能要到 2030 年至 2045 年才会显现。软件工程、金融分析和法律研究受到的影响尤其值得关注——这些领域恰恰依赖“从初级做起”的长期训练。

AI 还带来另一层更隐蔽的风险。人们需要专业知识来识别 AI 输出中的错误,而长期依赖 AI,又可能让这种专业知识更难积累。Lovett 把这种依赖称为“验证纽带”:有效监督 AI,需要深厚的领域经验。换言之,AI 越是替人完成入门工作,人越难获得监督 AI 所需的那份经验——这是一个自我强化的循环。

初级岗位减少,并不意味着初级工程师不再需要学习。

前 Meta 工程师、知名开发者教育者 Kent Dodds 在一期访谈中提出了一个不同角度的观察:工程师的职业路径本来就会从编写代码,逐渐延伸到团队管理、架构决策和系统设计。如果没有 AI,回到五年前来看软件工程师的职业发展路径,工程师越往上走,越会成为团队负责人,甚至技术 Fellow;职位越高,就越不可能了解自己管理的所有系统细节。

“现在,我们好像都成了技术 Fellow 或团队负责人,可以在不理解每个细节的情况下构建软件。”

但他同时强调,不能因为不必理解每一行代码,就认为软件自然会正常工作——雇一群缺乏经验的初级开发者写出糟糕的软件,产品创意再好也可能失败,技术严谨和明确方向依然不可或缺。

问题在于,成长路径本身正在改变。如果金字塔底部的新人不再需要掌握代码基础,他们以后怎样才能成长到管理 Agent 的层级?Dodds 的回答是:初级工程师成长为高级工程师,从来不是靠掌握语法本身,而是靠做高级工程师做的事、承担高级工程师的职责。

“既然高级工程师已经不再亲自写那么多代码,初级工程师也不必靠敲语法来达到同样的水平。”

当然,他们仍然会缺少一些经验,可能需要深入理解架构决策和不同方案之间的取舍。这一直都是成长过程的一部分。你要向上提升,就得往下钻,理解底层的东西。

但他认为,在没有技术基础的情况下成为架构师也是完全有可能的:“用现在的模型,要构建一个好系统,需要合适的基础构件;缺乏构建这类系统的经验,会让这件事非常困难。但困难并非不可能。我认为模型会继续进步——你只要告诉模型自己想要什么结果,它就能向你提出恰当的问题,确认自己理解了需求,然后构建出满足需求的系统。未来会走到这一步。”

如果“资深”的工作本身已变成指挥 Agent、做架构取舍、判断输出质量,那么入行通道就该围绕这些能力重建,而不是继续从语法练起。

Anthropic 选择了省事的那条路:只招已养成的人。这在单家公司身上完全理性,但所有公司都这样选时,短缺的不会是写代码的人,而是能判断 Agent 写得对不对的人——而这类人,招聘市场上没有现成供给。

参考链接:

https://officechai.com/ai/anthropic-has-seen-a-33-drop-in-junior-level-employees-since-early-2025-says-company/

https://www.anthropic.com/research/employment-at-anthropic

https://arxiv.org/pdf/2607.29380

https://www.youtube.com/watch?v=_BNWYC_DCQk

参考来源: InfoQ推荐
Huggingface发榜,中国模型StartLux稳居决策模型SOTA 配图

Huggingface发榜,中国模型StartLux稳居决策模型SOTA

核心内容
文章主要介绍了中国AI创业公司StartLux推出的决策模型StartLux-Decision-v1.1-27B Instant在Hugging Face的Decision Index榜单上登顶全球第一,并分析了StartLux在决策模型领域的突破和创新。
为什么重要
这个内容值得关注,因为它反映了全球AI领域的发展趋势,特别是在决策模型这一新兴赛道上的竞争态势。它体现了中国AI公司在全球AI领域的竞争力,对中国AI行业的发展具有重要影响。
关键洞察
StartLux通过深入理解和突破性创新,在决策模型领域取得了显著成就。其模型在Hugging Face榜单上连续霸榜,展示了其在该领域的领先地位。StartLux推出的RLCD²方法、DecisionPivot评测基准等创新成果,推动了全球决策模型的发展。
潜在影响
这一成就将对中国AI创业公司产生积极影响,激发更多企业在决策模型领域投入研发。同时,它也将推动全球AI技术的发展,特别是在决策模型的精度和应用场景方面。

ITValue

2026.10.18 12:20

展开全文收起全文剩余 76 段 · 约 10 分钟

· 来自北京

全文3438字

00:00 / 08:59

当 AI 从“生成内容”迈向“执行任务”,一个能够控制计算成本、理解关键细节并准确表达不确定性的决策中枢,将成为智能体和全本地智能系统不可或缺的基础设施。

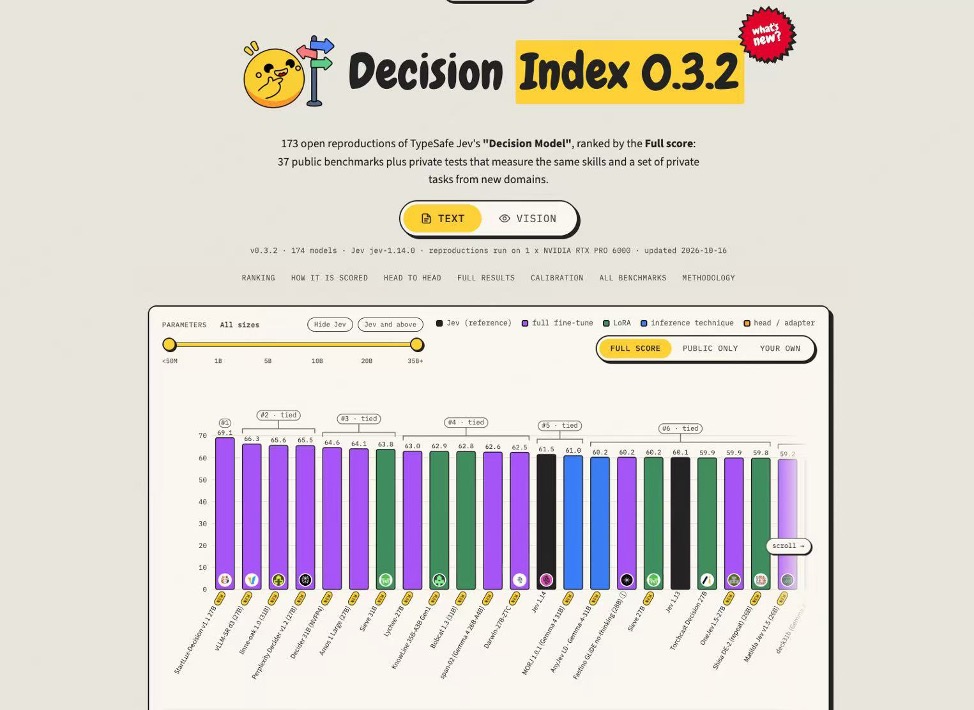
全球知名AI开源社区Hugging Face上的Decision Index 0.3.2榜单近日更新,中国AI创业公司StartLux(原点星辉)推出的StartLux-Decision-v1.1-27B Instant以69.1分登顶全球第一,在173项公开复现模型中排名榜首,领先第二名近3分,也是榜单中唯一突破69分的模型。继9月底发布首代模型后,StartLux仅用十余天再次刷新行业最佳成绩,稳居全球决策模型SOTA。

值得一提的是,StartLux已经不止于连续霸榜,新一代 StartLux-Decision 推出 Instant 与 AutoThink 两条路线,并原创提出RLCD² 方法,还带来DecisionPivot 评测基准、策略感知校准方法及两组动态多模态演示,推动了全球决策模型进一步向前发展。

凭借对决策模型的深入理解和突破性创新,StartLux得以持续霸榜全球决策模型,这也意味着中国AI 创业公司掌握了这一新兴赛道的绝对话语权。

登上 Hugging Face 榜首 连续保持 SOTA

此次 Hugging Face 的榜单纳入了 173项公开复现模型,并通过37项公开基准及多项私有测试进行综合评估;参与排名的StartLux新版决策模型StartLux-Decision-v1.1-27B-Instant领先第二名近3分,也是榜单中唯一突破69分的模型。

在另一测试中,StartLux同样拉开了性能差距。团队基于Decision Index 0.3的测试显示,StartLux-Decision-27B-AutoThink综合得分达到73.37,较美国AI公司TypeSafe推出的Jev(hosted)的57.96领先约27%。从Instant登顶第三方榜单,到AutoThink展现更强的复杂决策能力,StartLux已经形成覆盖快速判断与深度推理的全面优势,而这距离其9月底首次发布决策模型仅过去十天。

这已经不是 StartLux 第一次登上全球第一。9月30日,StartLux发布第一代开源决策模型StartLux-Decision。其27B版本在Decision Index 0.2.1中取得63.88分,超过Jev 1.13的57.91分,38项基准中有31项领先。此次升级后,27B AutoThink在Decision Index 0.3中的得分进一步提升至73.37,较Jev(hosted)的57.96领先约27%。短短十余天内两度刷新行业最佳成绩,StartLux完成了从单点性能突破到全系列领先的跃升,也让中国团队率先站上全球决策模型赛道的技术制高点。

Instant 与 AutoThink:简单题快答,难题再细想

决策模型是 AI 系统的“判断中枢”:请求交给谁、工具能否调用、检索结果是否可用,都由它快速判断。

新一代 StartLux-Decision 提供两种模式。Instant 是“极速判断版”,覆盖 0.8B 至 27B 五种规模,不生成推理过程,直接给出答案和信心分数,适合请求路由、内容分类等高频任务。AutoThink 是“按需思考版”,覆盖 4B、9B、27B:默认配置下,信心达到 0.9 就直接回答;信心不足时,才核对规则、计算数字并排查例外。

例如,476.80 瑞典克朗的商品,加上 24.03 运费可以通过;运费变为 24.05,就超过 500.84 的上限,必须拒绝。面对这种只差 0.02、结论却完全相反的问题,AutoThink 会把额外计算留给真正困难的判断。不过,让模型愿意思考只是第一步。如何避免它陷入冗长、无效的推理,并在得到有效结论后及时停止,则是 StartLux 此次更新要解决的另一个关键问题。

原创 RLCD²:中国模型已经不止于拿第一

会推理的模型很多,但能把每一步推理都花在刀刃上的并不多。为了让模型既能深入思考,又能及时收住,StartLux 原创提出 RLCD²强化学习训练方法,即 Reinforcement Learning for Calibrated Deliberative Decisions:如果推理真正改善了判断,就给予奖励;如果思考冗长、超过预算,就施加惩罚。

RLCD² 的效果非常明显。经过 RLCD² 训练,9B 模型能够自行结束推理的比例从 45.9%提高到 93.9%,平均推理长度从 2494 个 token 降至 868 个,减少约 65%,决策准确率基本保持不变。

这意味着,模型开始学会“该想时想、想清就停”,把算力集中到真正有价值的推理上。此次,StartLux 还系统公开了 RLCD² 的奖励设计、推理预算和实验结果,为决策模型如何高效思考提供了一套可分析、可验证的方法。

推出 DecisionPivot 评测基准 给决策模型一面更好的“镜子”

模型多想一步后,还要证明自己不是碰巧答对。团队为此设计的DecisionPivot 测评基准。它像一套专门检验细节辨别能力的考题,将条件相近、结论不同的题目组成一组,只有整组全部答对才计分。在 7800 道核心题中,StartLux-Decision-27B-AutoThink 以 86.9% 的成对准确率位列第一,在筛选、状态核验、排班冲突等需要计算和逐项检查的任务上展现出突出优势。

答对之外,模型还要准确判断自己答对的可能性,不能明明容易出错,却给出过高的信心分数。在 9B 模型的一组测试中,单条答案置信度处于 80%至90%时,实际正确率为 92%;但从 32 个候选中选出最高分答案后,同一置信度区间的正确率变为 78%。

为此,StartLux 提出策略感知校准,结合候选数量、平均分和筛选方式修正最终概率。在 184 组设置中,置信度与准确率的差距范围由 −11.7 至 +20.5 个百分点,收窄至 −2.7 至 +2.1 个百分点,让系统更准确地判断结果应自动执行还是交由人工复核。

广受开发者欢迎,模型下载量突破 12 万

StartLux-Decision 的领先不只属于 27B。在 DI 0.3 公开部分的评测中,4B AutoThink 获得 68.21 分,超过多款规模更大或以托管方式提供的模型。这意味着,决策能力不再只是参数规模的竞争,针对性的训练与推理机制同样能够释放强劲性能。该系列已公开全部权重和推理代码,支持本地部署,让开发者能够根据业务成本、响应速度和数据隐私要求,选择适合自己的模型规模与运行方式。截至北京时间 10 月17 号下午, StartLux 决策模型累计下载量近12 万。

此次更新还将决策能力拓展至动态多模态场景。团队通过火箭发射、洪灾救援两段视频,演示模型如何结合连续画面、字幕与上下文,同时处理多项判断,并根据置信度决定是否深入思考。这些案例打开了一扇通往真实世界的大门:决策模型不再局限于回答一道静态问题,而是开始面对持续变化的环境,在海量信息中迅速判断、主动思考、动态更新结论。

从小模型高性能到本地部署,从按需思考到多模态决策,StartLux-Decision 不仅展示了持续迭代和优化模型的技术实力,更标志着其正以技术引领者的姿态,提出原创理论与方法,推动整个决策模型行业向前迈进。当 AI 从“生成内容”迈向“执行任务”,一个能够控制计算成本、理解关键细节并准确表达不确定性的决策中枢,将成为智能体和全本地智能系统不可或缺的基础设施。新一代 StartLux-Decision,正在加速这一未来到来。

本文系作者 ITValue 授权钛媒体发表,并经钛媒体编辑,转载请注明出处、作者和本文链接。

本内容来源于钛媒体钛度号,文章内容仅供参考、交流、学习,不构成投资建议。

想和千万钛媒体用户分享你的新奇观点和发现,点击这里投稿 。创业或融资寻求报道,点击这里。

787人已赞赏 >

敬原创,有钛度,得赞赏

赞赏支持

快报

更多

08:01

三星据悉将采用台积电3纳米工艺为英伟达生产下一代HBM基底裸片

08:00

伊朗总统:绝不屈服于“侵略性”国家无理要求与霸凌

07:55

联合国《生物多样性公约》第十七次缔约方大会开幕

07:47

资金避险需求升温,债基扎堆限购

07:45

供给提速资产扩围,公募REITs长期配置价值渐显

07:41

俄副总理:俄柴油将在签署合同后15-20天进入美市场

07:39

以总理公布新“国家安全构想”,称转向进攻和预警打击

07:28

伊拉克外长:正推动伊朗与海湾国家举行会谈

07:25

胡塞武装称沙特24小时内发动110次袭击

07:24

泽连斯基与美特使通话,讨论外交解决乌克兰危机

07:21

Anthropic计划将部分股份转入新设“公共利益”基金

07:18

消息称AI云厂商Nscale IPO估值目标遭投资者反对:砍半才有人买单

07:10

美联储10月维持利率不变的概率为83.9%

07:09

把握市场震荡中的“击球机会”,年内私募自购近16亿元

07:08

A股分红回购增持热潮涌动

07:02

生成式AI能从原子层面设计蛋白质

2026-10-18 22:45

下周(10月19日-25日)市场大事预告

2026-10-18 22:30

千余家影院直播体育赛事

2026-10-18 22:20

中国秋粮收获进度过七成

2026-10-18 21:36

何立峰会见中投公司国际咨询委员会委员

扫描下载App

参考来源: 钛媒体
The Tesla Roadster 2 Is Here—and It Flies 配图

The Tesla Roadster 2 Is Here—and It Flies

核心内容
文章主要介绍了特斯拉最新发布的Roadster 2车型,一款声称是公司最后一款由人类驾驶的汽车,具备飞行功能,并且有望在2028年开始生产。
为什么重要
这个内容值得关注,因为它标志着特斯拉在汽车技术领域的又一重大突破,反映了电动汽车和飞行汽车技术发展的新方向,同时可能对汽车行业、交通法规和消费者心理产生深远影响。
关键洞察
最有价值的观点是特斯拉Roadster 2具备飞行功能,通过四个喷气推进器实现飞行,预计最高时速可达385英里(约620公里),并且单次充电续航超过300英里。此外,Roadster 2预计将提供三种版本:性能版、赛车版和火箭版,其中火箭版为“邀请制”,赛车版为“限量版”。
潜在影响
特斯拉Roadster 2的发布可能会影响汽车行业的竞争格局,促使其他汽车制造商加速研发类似产品。同时,飞行汽车技术的应用也可能推动相关交通法规的制定和更新,并对消费者对汽车功能和性能的期待产生影响。

Skip to main content

On Thursday night, Tesla and CEO Elon Musk unveiled what’s been billed as the company’s last human-driven car. Maybe human-piloted is a more accurate way to say it.

展开全文收起全文剩余 13 段 · 约 10 分钟

At a demonstration event in McGregor, Texas—at SpaceX’s rocket development and testing facility—the new car did what Musk has long promised. With a herky-jerky burst of steam, it flew into the air. At one point, the car appeared to flip over the automaker’s entire line-up, floating several feet over its electric semi-truck. Tesla executives said the vehicle could accelerate from 0 to 60 mph in one second.

“This is not necessarily a safety-optimized car,” Musk said. (It’s also likely to raise the eyebrows of federal regulators.)

Tesla says it will begin production on the Roadster 2 in 2028. Fans have waited a long time for the vehicle. The Roadster 2—the successor to Tesla’s first vehicle, the Roadster—was first announced in 2017, and at the time Tesla said the new sports car would be the fastest production vehicle in the world.

The “flying” technology is enabled by four thrusters, Tesla vehicle engineering head Lars Moravy said. He said the production version would “hopefully” travel up to 230 miles per hour, though Musk said he hoped to “crack halfway to the speed of sound”—around 385 mph. Modern Formula 1 vehicles usually top out around 220 mph. The company said the vehicle would travel more than 300 miles on one charge, middling for a mainstream EV and lower than most luxury vehicles. Tesla’s own Model 3 can travel up to 360 miles on a charge.

Tesla said the thrusters are powered by onboard compressed gas. Musk said that the same technology that allows the vehicle to fly will also create downward force that allows the vehicle to turn corners very quickly. “It’s going to crush every track record that has ever existed,” he said.

The company initially promised the Roadster 2 would ship in 2020. On Thursday, the Tesla team did mention the new timeline, but did not mention what the new car will cost. Musk has a long history of not following through on his loftiest product ambitions, and timelines for many Tesla releases have repeatedly missed targets.

The company posted on X that the Roadster 2 would come in three variants: a two-seater “Performance” road-ready version that lacks the thrusters Tesla showed off on Thursday; a “race ready” Thrust variant; and an “air ready” Rocket variant that has only one seat. The Tesla website lists the Rocket as “invite only” and the Thrust as “limited.” You can currently only place reservations for the Performance and Thrust versions.

A Tesla Flying Car? I Don’t Know, Man

The Federal Aviation Administration will likely have thoughts about the Tesla Roadster 2’s ability to leave the ground.

When it was first announced, enthusiasts put down $50,000 deposits for what was advertised as a $200,000 car. (That deposit is worth more than $68,000 in 2026 dollars.) Some got sick of waiting. OpenAI CEO Sam Altman complained on X last year that he had trouble canceling his reservation. Musk posted that Altman received a refund in 24 hours.

A reservation page posted on Tesla’s site now charges a $5,000 reservation fee for the Performance variant, with an additional $45,000 due within 10 days. The Thrust is available for an initial $5,000 fee, with $245,000 due within 10 days.

Musk has said that Tesla should no longer be regarded as a carmaker and that the company is focused on building autonomous vehicle technology and robots.

The unveiling event comes at a weird time for electric vehicles. Sales of EVs have stalled in the US after the GOP-led Congress nixed federal support. Meanwhile, the global energy crisis has EV sales booming elsewhere. Electric luxury hypercars—the class to which the Roadster 2 belongs—are in an especially tricky spot. Several luxury automakers have said that wealthy buyers are now looking for the sound and power of a typical gas-powered vehicle. Lamborghini shelved its plans to make an EV earlier this year.

参考来源: Wired
✨ AI 助手