第 11 期 · 2026-W40 2026年09月27日 — 10月04日
✦ 本周速览

本周 AI 领域重磅迭起,谷歌刚刚发布的 Gemini 4 Argon 以碾压 GPT-6 Astra 的基测成绩及参与内核代码迁移的硬核实力,重新定义了大模型边界。最值得读的是这篇头条,它将带您深入了解这场技术风暴背后的细节;此外,我们还精选了 Anthropic 的 Crispr 类系统发现、抑制间接提示注入的 CounterSteer 技术,以及关于 AI 理解的多声部思考。

刚刚,Gemini 4 Argon 发布:多项基测碾压 GPT-6 Astra,已参与谷歌 80 万行内核代码迁移 配图
头 条

刚刚,Gemini 4 Argon 发布:多项基测碾压 GPT-6 Astra,已参与谷歌 80 万行内核代码迁移

核心内容
文章介绍了谷歌最新发布的面向复杂工程与长流程任务的模型 Gemini 4 Argon,该模型已通过 Fairwind 计划在内部及受信团队中用于编程、量子计算及网络安全防御。
为什么重要
这一发布标志着大模型能力从单纯的文本生成向复杂长流程工程执行跨越,反映了生成式 AI 正从“对话工具”向“自主执行软件”转型的关键趋势。
关键洞察
Argon 将输出上限提升至 100 万 Token 并以极低价格(输入 2 美元/百万 Token)上市,这种“超大上下文+低成本”的组合策略是其在软件工程基测中碾压竞品的核心优势。
潜在影响
受影响的将是谷歌的云服务客户及大型企业,可能引发软件工程领域从“代码辅助”向“代码自动迁移与修复”的变革。

# 刚刚,Gemini 4 Argon 发布:多项基测碾压 GPT-6 Astra,已参与谷歌 80 万行内核代码迁移

刚刚,谷歌宣布推出新一代模型 Gemini 4 Argon,重点面向长流程软件工程、法律与金融等企业知识工作,以及网络安全防御场景,当前仅通过 Fairwind 计划定向开放给受信安全团队。

展开全文收起全文剩余 22 段 · 约 5 分钟

谷歌 CEO Sundar Pichai 在 X 上宣布该消息时写道:“外界最近对我们的下一款模型有很多讨论,所以我想尽早让大家先睹为快。现在,向大家介绍 Gemini 4 Argon!它在复杂工作流、网络安全防御和软件工程方面展现出前沿水平的性能。谷歌内部团队已经在广泛使用它,应用范围从编程到量子计算,反馈非常好。”

从技术博客披露的内容来看,谷歌此次强调的重点,是模型能否持续处理复杂、多步骤任务,以及这些能力如何进入实际工程和业务流程。该模型支持复杂多步任务持续执行,已内部验证于编程至量子计算等工程链路。

此次发布采用分阶段开放方式。Argon 目前通过 Fairwind 计划向一批受信任的网络安全防御团队开放,尚未面向所有开发者和消费者上线。谷歌表示,将根据早期测试反馈继续调整安全防护措施,后续开放将从付费 API 客户和 Google AI Ultra 订阅用户开始,但未公布具体时间。

价格方面,谷歌表示 Argon 将以优惠价上市。上线初期每百万输入 Token 为 2 美元,每百万输出 Token 为 10 美元;缓存输入 Token 的价格较普通输入低 95%,显著优化长上下文推理成本。

## 输出上限从 64K 提高至百万 Token

Argon 的一项主要变化,是输出 Token 上限从此前的 64K 提升至 100 万。这里的百万 Token 指的是输出上限,而非输入上下文窗口。

谷歌认为,更大的输出空间能够让模型在单条执行轨迹中进行更深入的推理、生成数十万 Token,从而支持更长、更复杂的任务。对于软件迁移、金融研究和企业流程执行,这一设计试图解决的是任务持续性问题:模型需要在多轮分析、验证与修改中推进工作,而不仅是生成一次回答。

不过,输出上限本身并不等于任务完成能力,实际效果仍取决于模型能否保持目标一致、正确调用工具,并发现和纠正执行过程中的错误。

## 基准测试表现

按照谷歌公布的结果,Argon 在衡量真实、长流程软件工程能力的 DeepSWE v1.1 中取得 77.9%,谷歌称其创下该评测的新纪录。

企业任务方面,谷歌表示,Argon 在覆盖金融、编码、法律和税务工作的 Vals Index 中处于领先位置,在多步骤金融研究评测 Vals Finance Agent v2 和 Harvey 法律智能体评测中,也取得领先表现。该指数衡量金融、编码、法律和税务工作的经济影响,每个行业都根据其对美国 GDP 的贡献进行加权。

此外,Argon 在 Zapier 的 AutomationBench 中以 51.3% 排名第一,该基准测试衡量核心业务功能的端到端执行力。

Argon 在需要视觉理解的知识型工作中也展现出独特的优势。它能够进行专业的图表分析,从长视频中识别细节,并根据一系列文档采取行动。例如,在衡量长视频理解能力的 LVBench 测试中,Argon 的得分高达 91.7%,处于行业领先水平。

## 从生成代码,走向代码库迁移与性能优化

与评测分数相比,谷歌披露的内部工程案例,更具体地展示了 Argon 的使用方向。

谷歌称,Argon 智能体正在参与公司内部 C/C++ 代码库向 Rust 的迁移,规模从 re2、libgav1 等核心库的数万行代码,扩展至 Fuchsia 操作系统 Zircon 内核的 80 多万行代码。这并不意味着相关迁移已经全部完成或投入生产。谷歌明确表示,考虑到这些系统的重要性,大规模重写仍需经过严格的自动化和人工审计、仿真测试与评审。

在开源视频解码软件 libgav1 的案例中,Argon 智能体基于已有 Rust 移植版本,替换了约 3.2 万行 SIMD 代码。其工作包括多轮由性能剖析结果指导的实验、研究编译器输出,以及生成能够由编译器自动向量化的安全 Rust 代码。按照谷歌的说法,优化后的视频解码器保持相同的视频输出,运行速度达到原 Rust 移植版本的 2.7 倍,进一步接近经过优化的 C++ 实现。这里的比较对象是此前的 Rust 移植版本,不能理解为其性能已经达到 C++ 版本的 2.7 倍。

谷歌还披露,一组 Argon 智能体通过分析服务器集群的性能遥测数据,自主识别和实施数据中心内存优化。相关优化部署后,已释放超过 300 TiB 内存,预计总节省量可达到 500 TiB 至 1 PiB。

在量子算法研究中,Argon 则被用于优化关键子程序的时空资源开销。谷歌表示,在一个案例中,模型仅用几分钟便取得了比已发表基准方案好 40% 的结果。博客没有进一步披露该案例的具体任务与完整实验条件。

这些案例共同指向一种使用方式:让模型进入分析、修改、测试和优化的连续工程流程,并以程序性能、资源消耗或功能一致性检验结果。

## 网络安全能力先向受信任团队开放

网络安全防御是 Argon 此次优先开放的领域。谷歌表示,为了更好地帮助网络安全防御者应对新时代的网络攻击,他们对 Gemini 4 Argon 进行了训练,使其具备强大的网络安全防御能力。Argon 可以自主发现、验证并修复关键软件漏洞。

参考来源: InfoQ推荐
AI

CounterSteer: Suppressing Indirect Prompt Injection with Activation Steering

核心内容
这篇文章主要介绍了一种名为CounterSteer的新方法,用于抑制大型语言模型(LLM)中常见的间接提示注入攻击。这种方法通过一种五步流程来拟合残差流方向,并在推理时从工具结果token中减去该方向,以防止LLM执行不可信的检索文本。
为什么重要
CounterSteer的重要性在于它为LLM的安全防御提供了新的思路,特别是在对抗间接提示注入这类攻击时。这种方法的提出和实施反映了当前对于提高LLM安全性和鲁棒性的迫切需求,同时也影响了LLM在实际应用中的信任度和接受度。
关键洞察
CounterSteer最关键的洞察是,它能够在不引入额外微调或辅助模型的情况下,显著降低间接提示注入攻击的成功率。实验结果显示,CounterSteer在各种大型开放权重模型上都能有效抑制攻击,同时保持了较高的良性任务效用。
潜在影响
CounterSteer的潜在影响将主要体现在以下几个方面:1)对于LLM的安全研究者来说,CounterSteer为防御间接提示注入攻击提供了新的工具和思路;2)对于LLM的使用者来说,CounterSteer能够提升LLM的安全性,增强用户对LLM的信任;3)对于LLM的开发者来说,CounterSteer可能促使他们重新考虑LLM的设计和实现,以增强其防御能力。

# CounterSteer: Suppressing Indirect Prompt Injection with Activation Steering

**作者:**Mark Russinovich

展开全文收起全文剩余 6 段 · 约 2 分钟

**提交日期:**2026年9月29日(arXiv:2609.36570,计算机科学 > 密码学与安全)

**摘要:**

间接提示注入(indirect prompt injection)会使 LLM 智能体将不可信的检索文本当作指令执行。本文提出 CounterSteer——一种推理时防御机制,在模型内部抑制此类行为。

具体方法上,针对每个模型,一个五步流程利用仅在"嵌入指令是否被遵循"这一点上存在差异的成对 episode,拟合出残差流(residual-stream)方向;该方向只有在通过预先设定的因果门和能力门检验后才会被保留。部署时,在 prefill 阶段,该方向会从每个工具结果 token 中被减去。该修改始终生效——不存在可被绕过的检测决策——且无需微调、辅助模型或新增 token,仅需白盒服务能力和工具结果区间的边界信息。

实验在五个开放权重模型(8B–106B,涵盖五个厂商系列)上进行:held-out 攻击成功率从未防御时的 0.21–1.00 降至防御后的 0.00–0.17;AgentDojo 攻陷率从 0.10–0.49 降至 0.006–0.079;同时保持 93–100% 的排版归一化良性任务效用,不过在处理被引导内容时会产生随任务而变的较大开销。一个在基准层面自适应的攻击者在未防御时可达 0.67–0.73 的攻击成功率,在两个评估最深入的模型上被压制到约四分之一的水平。在我们针对能力较强模型所测量的各类防御中,那些攻陷率更低的方案要么损失了 22–89% 的良性效用,要么微调了服务权重。针对部署向量的白盒梯度攻击在 52 个 episode 中最多攻陷 2 个,在 2,052 次回放的人类红队攻击中无一成功。

CounterSteer 在很大程度上中和了指令性接管:黑盒框架搜索仅在 18 个开发样本中攻破了 3 个。但参数操纵(即在看似合法的调用中植入攻击者选择的参数)仅被部分抵御(18 个样本中 13 个被突破):该决策在参数生成时线性可读,但在考察的生成前位置不可读,且测试过的 prefill 时或解码时引导均无法将其消除,这促使我们需要引入参数来源(argument-provenance)控制机制。

参考来源: ArXiv AI

A Polyphonic Conception of AI Understanding

核心内容
这篇文章主要探讨了人工智能理解的多声部概念,提出了一个适合多声部AI的理解观念,旨在帮助人类在评估AI模型的输出时建立信任。
为什么重要
这个内容值得关注,因为它挑战了传统的AI理解模型,提出了一种新的多声部模型,这对于理解和评估AI的输出至关重要。同时,它反映了人工智能领域的最新研究方向,即AI理解和可解释性的研究。
关键洞察
最有价值的观点是,AI的理解并不是单一机制的结果,而是多个机制并行运作、互相补充的结果。这种多声部理解不仅使对理解责任的归因复杂化,而且使得单一的推理模式变得危险。文章提出的观念认为,理解应该围绕可靠和正确运作的电路图,使理解责任的归因变得可处理。
潜在影响
受影响的将是人工智能开发者、研究者、应用者和监管者。这一观念可能改变我们对AI的理解和评估方式,促使AI系统的设计更加可靠和可解释,从而提高人类对AI的信任,并可能促进AI在更多领域的应用。

Skip to main content · Press Enter to search · Advanced search · Computer Science > Artificial Intelligence · arXiv:2609.36079 (cs) · [Submitted on 28 Sep 2026] · Title:A Polyphonic Conception of AI Understanding · Authors:Matthieu Queloz, Pierre Beckmann

View a PDF of the paper titled A Polyphonic Conception of AI Understanding, by Matthieu Queloz and Pierre Beckmann

展开全文收起全文剩余 75 段 · 约 9 分钟

View PDF HTML (experimental)

Abstract:When a doctor, a judge, or an engineer must decide whether to trust an AI model's output, they cannot avoid asking what the model understands. Purely mathematical or statistical descriptions struggle to distinguish trustworthy from untrustworthy outputs without reintroducing the question of AI understanding in all but name. Yet the question is ill-framed as it stands, because the inherited concept operates within a monophonic paradigm: the idea that a cognitive system's understanding of something must be localised to a single mechanism underpinning all the capacities conferred by such understanding. Drawing on a wide range of mechanistic evidence, we show that LLMs are pervasively polyphonic: outputs emerge from coalitions of parallel mechanisms of uneven reliability, which variously complement, duplicate, or drown out one another, with several coalitions sufficing for a task without any one being indispensable. Polyphony not only complicates attributions of understanding, but renders monophonic inference patterns hazardous. In response, we develop a conception of understanding fit for polyphonic AI. It centres on sound circuitry that is reliably and correctly recruited and in control of outputs. Attributions of understanding thereby become tractable claims about internal organisation, and can do the work of guiding trust in AI.

Submission history

From: Pierre Beckmann [view email]

[v1] Mon, 28 Sep 2026 18:25:44 UTC (202 KB)

Full-text links:

Access Paper:

View a PDF of the paper titled A Polyphonic Conception of AI Understanding, by Matthieu Queloz and Pierre Beckmann

View PDF

HTML (experimental)

TeX Source

view license

Current browse context:

cs.AI

< prev | next >

new | recent | 2026-09

Change to browse by:

cs

cs.CL

References & Citations

NASA ADS

Google Scholar

Semantic Scholar

Loading...

BibTeX formatted citation

loading...

Data provided by:

Bookmark

Bibliographic Tools

Bibliographic and Citation Tools

Bibliographic Explorer Toggle

Bibliographic Explorer (What is the Explorer?)

Connected Papers Toggle

Connected Papers (What is Connected Papers?)

Litmaps Toggle

Litmaps (What is Litmaps?)

scite.ai Toggle

scite Smart Citations (What are Smart Citations?)

Code, Data, Media

Code, Data and Media Associated with this Article

alphaXiv Toggle

alphaXiv (What is alphaXiv?)

Links to Code Toggle

CatalyzeX Code Finder for Papers (What is CatalyzeX?)

DagsHub Toggle

DagsHub (What is DagsHub?)

GotitPub Toggle

Gotit.pub (What is GotitPub?)

Huggingface Toggle

Hugging Face (What is Huggingface?)

ScienceCast Toggle

ScienceCast (What is ScienceCast?)

Demos

Replicate Toggle

Replicate (What is Replicate?)

Spaces Toggle

Hugging Face Spaces (What is Spaces?)

Spaces Toggle

TXYZ.AI (What is TXYZ.AI?)

Related Papers

Recommenders and Search Tools

Link to Influence Flower

Influence Flower (What are Influence Flowers?)

Core recommender toggle

CORE Recommender (What is CORE?)

Author

Venue

Institution

Topic

About arXivLabs

arXivLabs: experimental projects with community collaborators

arXivLabs is a framework that allows collaborators to develop and share new arXiv features directly on our website.

Both individuals and organizations that work with arXivLabs have embraced and accepted our values of openness, community, excellence, and user data privacy. arXiv is committed to these values and only works with partners that adhere to them.

Have an idea for a project that will add value for arXiv's community? Learn more about arXivLabs.

Which authors of this paper are endorsers? | Disable MathJax (What is MathJax?)

参考来源: ArXiv AI
Bun 在四个月内将 53.5 万行 Zig 代码重写为 Rust,消除了大量内存泄漏 配图

Bun 在四个月内将 53.5 万行 Zig 代码重写为 Rust,消除了大量内存泄漏

核心内容
文章主要讲述了Bun运行时团队在四个月内将53.5万行Zig代码重写为Rust的过程,这一转变旨在利用Rust的内存安全特性来消除内存泄漏问题。
为什么重要
这个内容值得关注,因为它展示了使用Rust语言在提高代码安全性方面的潜力,同时也反映了软件工程领域对内存安全问题的重视。此外,它还可能对其他使用类似技术栈的项目产生启发,推动更多团队转向使用Rust来提升代码质量。
关键洞察
最有价值的观点是Rust编译器能够静态捕获内存错误,如释放后使用等,这显著提高了代码的内存安全性。此外,文章指出AI辅助工具的使用显著缩短了重写周期,提高了开发效率。
潜在影响
谁会受影响的是那些依赖内存安全性的软件开发者和项目。这种转变可能会促使更多的项目考虑使用Rust,尤其是在需要高安全性和性能的领域,如金融科技、安全系统和嵌入式系统。这可能会带来软件开发模式的变化,包括对Rust语言技能的需求增加。

作者:Bruno Couriol

平川

展开全文收起全文剩余 35 段 · 约 7 分钟

2026-09-29

北京

本文字数:2173 字

阅读完需:约 7 分钟

AI摘要

Bun 运行时完成从 Zig 到 Rust 的重写,核心目标是借助 Rust 借用检查器根除内存安全漏洞,4 个月内交付而非原计划一年。

关键观点:Rust 编译器可静态捕获释放后使用等内存错误;测试套件基于 TypeScript,解耦语言迁移与功能验证;AI 辅助显著压缩重写周期。

适合 JavaScript/TypeScript 运行时开发者、Rust 系统工程师、前端工具链架构师阅读。

Bun 的创建者 Jarred Sumner 近日宣布,这款集 JavaScript/TypeScript 运行时、打包工具和包管理器于一体的工具已经从 Zig 重写为 Rust。这次重写主要是通过 Rust 的借用检查器消除反复出现的内存安全漏洞。这项在人工智能辅助下进行的重写工作历时 4 个月便完成并发布,而非原先预计的一年。

这一举措最初是作为概念验证项目启动的,Sumner 总结了背后的动机:

在错误路径中,有很大比例的 Bug […]属于“释放后使用”、“双重释放”以及“忘记释放”的情况。在安全的 Rust 语言中,这些都会被编译器识别为错误,并且通过 Drop 实现了类似 RAII 的自动清理。与代码风格指南相比,编译器错误能提供更好的反馈机制。

从历史经验来看,重写是一个糟糕的主意。[…] Bun 共有 535496 行 Zig 代码。如果用另一种语言重写,需要花费掉一个小型工程师团队整整一年的时间。这意味着在一年的时间里,漏洞修复、安全修复或功能开发都将被迫暂停。

幸运的是,Bun 自身的测试套件是用 TypeScript 编写的,这意味着它不依赖于运行时的编程语言。

如果我花一周时间测试 Anthropic 的新模型能否用 Rust 重写 Bun,会怎样呢?

起初,我并不指望它能成功。但几天后,测试套件的通过比例大幅上升,我发现新生成的 Rust 代码与原始的 Zig 代码库高度吻合。我的看法也从“这值得一试”转变为“我要把这个合并进去”。

Sumner 执行了一次自动化的“一次性”移植,整个重写过程中的大部分工作都是利用了 Claude Fable 5 的预发布版本,通过约 50 个动态工作流进行协调。Zig 代码被转译为 Rust(或许可以使用 unsafe Rust 并稍后进行重构),并使用当前包含超过一百万条断言的庞大测试套件进行了验证。移植指南可以帮助 Claude 将 Zig 的模式和类型映射到 Rust 的模式和类型。通过对抗性的智能代理代码审查,可以在进入最终移植阶段之前进一步检测问题。每次出现错误后,他都通过优化实现流程(而非手动修复实现产物,例如代码)来改进实现循环。

持续的流程改进揭示了一些有用的规律。规划阶段对于成功的迁移至关重要,非常有必要通过这个阶段预见并缓解一些关键的挑战。PORTING.md(描述了从 Zig 到 Rust 的映射)和 LIFETIMES.tsv 文件(描述了代码库中每个结构体字段的生命周期)是这次移植的关键成功因素。

随后,实现者代理将利用这些文件将 Zig 文件转换为 Rust 代码。实现者代理将面临两个对抗性审查代理,它们在单独的上下文窗口中运行,仅能访问文件差异,其唯一任务就是发现错误和行为偏差。Sumner 强调说:

实现者不负责审查。审查者不负责实现。

审查者代理提出的建议和发现的问题由修复代理处理。

在很大程度上,实现过程的效率得益于实现任务的并行化。但这需要解决共享代码库的并发更新问题,以及计算资源有限的饥饿问题。

最终,这项工作被分配到四个工作区分片中,每个分片运行 16 个代理,并行运行的 Claude 实例总共有 64 个。在最快情况下,系统每分钟生成约 1300 行代码,每小时最多提交 695 次。

要使整个测试套件全部通过,需要耗费价值 16.5 万美元的 Token——这与 Sumner 对人工工程工作量的估算形成了鲜明的对比:

合并前,这消耗了 59 亿个未缓存的输入 Token、6.9 亿个输出 Token,以及 720 亿次缓存输入令牌读取——按 API 定价计算,费用约为 16.5 万美元。如果靠人工,我认为需要 3 名完全熟悉这个代码库的工程师耗时约一年的时间才能完成。

当 100 多万行代码最终通过了测试套件后,我们进行了进一步的测试和验证,发现了更多问题。

移植过程中的机械操作引入了 19 个微妙的语义回归,其根源在于 Zig 和 Rust 之间的语法相似性。Claude Code Security 进行的 11 轮安全审查修复了多个安全问题。他们对 Bun 中的每个解析器进行了 7x24 小时不间断地覆盖率引导式模糊测试,其间共产生了 15 个 PR。

据 Bun 团队称,通过 Rust 重写实现的 Bun v1.4.0 不仅修复了 v1.3.14 中长期存在的 128 个 Bug,还带来了显著的性能收益。原生内存泄漏问题已经得到解决。在进程内打包测试中连续执行 2000 次 Bun.build() 操作时,内存占用在 Rust 环境中稳定维持在 609 MB,而非像之前那样攀升至超过 6.7 GB。HTTP 吞吐量提高了 2% 至 5%。

Bun v1.4.0 最终于 2026 年 8 月发布。

Zig 语言创建者 Andrew Kelley 发表了一篇尖锐的批评文章,题目为“我对 Bun 用 Rust 重写的看法”,其中包含以下评论:

这里体现了一种二分法:为了避免 Bug,你必须在“风格指南”和编程语言特性之间做出选择。这种障眼法将读者的注意力从消除 Bug 的主要途径上转移开,即投入工程资源来解决这个问题。[……]

主张将所有 100 万行未经审查的代码直接发布出去的理由是,测试套件足够完善,能够捕获所有问题。那么,为什么你说你的 Zig 代码中存在这么多令人头疼的 Bug 呢?那个“测试套件足以捕获所有问题”的说法去哪儿了?它不足以捕获 Zig 代码中的 Bug,却足以捕获 100 万行未经审查的粗制滥造的 Rust 代码中的 Bug?

与此同时,用户 vitaminCPP 指出,超过 100 万行机器转译代码的整合,使 Bun 成为一个关键的行业预警风向标,用以检验由大型语言模型(LLM)生成的庞大代码库在软件工程生命周期中是否仍然能够保持可维护性。

建议开发者阅读全文,其中包含深入的技术解析以及相应的插图和图表。

Bun 于 2025 年 12 月被 Anthropic 收购。

原文链接:https://www.infoq.com/news/2026/09/bun-AI-rewrite-zig-rust-4-months/

参考来源: InfoQ推荐
OpenAI DevDay 2026 live blog 配图

OpenAI DevDay 2026 live blog

核心内容
这篇文章主要记录了作者在OpenAI DevDay 2026活动中的所见所闻,包括对主旨演讲的实时报道,以及介绍新产品"Dots"的功能和特点。
为什么重要
这篇文章的重要性在于它提供了对OpenAI最新发展和产品发布的直接视角。它反映了人工智能领域的最新进展,特别是OpenAI在AI助手和交互技术方面的创新,这对于科技行业和广大用户来说都是值得关注的内容。
关键洞察
最有价值的观点是关于新产品"Dots"的介绍。Dots是一个类似Muse的个人AI助手,它具有可爱的形象和强大的语音交互能力,运行在Astra模型上,这表明OpenAI在AI个人助理领域的新尝试和进步。
潜在影响
谁会受到影响包括科技行业从业者、AI产品用户以及普通消费者。这种新的AI助手可能会改变人们与人工智能交互的方式,推动AI技术的普及和应用,从而在多个层面上产生变化,如提高工作效率、改变娱乐方式等。

# OpenAI DevDay 2026 live blog

29th September 2026

展开全文收起全文剩余 18 段 · 约 7 分钟

I'm at OpenAI DevDay today, in Fort Mason, San Francisco. Same as last year I'll be live blogging the keynote and some other notes during the day. OpenAI gave me a free ticket and a seat in the "creator" area for the keynote.

**09:27** I'm in the room for the keynote, which starts in half an hour. This year I vibe-coded a system for more easily adding photos to my live blog. I intended to do that using Codex Cloud (I built it on my phone on the way to the venue) but ran into problems with that and switched to Claude Code for web instead.

**10:01** Sam Altman is on stage, welcoming us to DevDay. He promises "our best DevDay yet".

**10:02** Showing features they've shipped that people asked for. Codex on Linux and Codex on your phone both got some applause.

**10:03** Today, a product to feel like a "whole new way of working with AI". My guess is that it's a personal agent similar to Muse... It's called "Dots".

**10:05** It does look very Muse-like. You get to pick its name, then it's represented by a cute blob-like avatar. (My Muse avatar is a pelican.)

**10:06** This demo video includes a whole lot of voice interactions, presumably using GPT-Live or a new generation of that technology.

**10:07** Dots are "powered by Astra". That would be an expensive default model!

**10:08** A very ambitious use-case, migrating an API. I'm surprised that they went for such a code-heavy example so early on, I guess this is a developer audience.

**10:09** Sam called Astra "our most aligned model", to allow you to trust your Dot with "as much responsibility as you are comfortable with". "You also need a place for your team to collaborate with their Dots". So they are introducing ChatGPT Space.

**10:10** These Spaces look like shared artifacts, maybe Google Docs meets the artifacts pattern. Sam introduces Holly Li.

**10:11** Holly is talking through a scenario building a fictional music app. Holly has a Dot called "Dottie", which has access to ChatGPT, Slack, Teams, and more.

**10:12** This UI really does look like Meta's Muse agent, currently still at number one on the iOS App Store free list.

**10:13** Live demo! "Dottie is having a slow morning" - we got a "still checking" and an embarrassing silent moment.

**10:14** Now we're in ChatGPT Space. It has a Notion-style slash menu.

**10:16** People at OpenAI started delegating to their Dots directly in Slack, which have their own identities in OpenAI Slack. I guess this is OpenAI's answer to Claude Tag.

**10:17** "Dottie can use Codex on my laptop to build the app and launch it in the iPhone Simulator."

**10:18** ChatGPT Pro and Enterprise customers get access to Dots today.

参考来源: Simon Willison

EngiWorld: What Can Frontier Agents Deliver in Professional Engineering Environments?

核心内容
文章主要介绍了EngiWorld,这是一个围绕完整设计循环构建的基准测试,旨在评估自主代理在专业工程环境中的表现。它涵盖了多个工程领域和软件平台,并引入了一种以工件为中心的评估方法。
为什么重要
这个内容值得关注,因为它揭示了在专业工业工程中实现可靠自动化所面临的挑战,同时提供了一个新的基准测试来衡量自主代理在专业工程软件全流程操作方面的进展。这反映了人工智能在工程领域的应用潜力和挑战。
关键洞察
最有价值的观点是EngiWorld的评估结果显示,即使是最强大的模型在EngiScore上也只达到了44.3,且只有3.6%的多软件尝试成功。这表明在专业工程环境中实现可靠自动化还有很长的路要走。
潜在影响
这将影响工程领域的专业人士和研究人员,可能会促使他们更加重视在工程自动化和人工智能应用方面的研发,并可能推动相关技术和工具的发展。

Skip to main content · Press Enter to search · Advanced search · Computer Science > Artificial Intelligence · arXiv:2609.37686 (cs) · [Submitted on 29 Sep 2026]

Title:EngiWorld: What Can Frontier Agents Deliver in Professional Engineering Environments?

展开全文收起全文剩余 77 段 · 约 10 分钟

Authors:Hongcheng Gao, Hailong Qu, Yu Lei, Henghui Sun, Haoyang Li, Yipeng Wei, Naihao Xue, Xiaohan Yu, Zhuo Tao, Yihe Zang, Yajiao Wang, Jingyi Tang, Yi Li, Jingjing Zhou, Jie Luo, Bohan Zeng, Chengyu Shen, Hao Jiang, Chong Chen, Bowen Qu, Olive Huang, Zeqiang Wang

View a PDF of the paper titled EngiWorld: What Can Frontier Agents Deliver in Professional Engineering Environments?, by Hongcheng Gao and 21 other authors

View PDF HTML (experimental)

Abstract:Autonomous agents have made rapid progress in general-purpose computer use, but reliable automation of professional industrial engineering remains out of reach, as engineering workflows demand reasoning over geometric and physical constraints and dependencies preserved across software and design stages. We present EngiWorld, the first benchmark structured around the complete design loop: 1,301 expert-curated tasks spanning 6 engineering domains (CAD, CAE, CAM, BIM, EDA, and 3D visualization) and 26 professional software platforms, with both GUI and CLI interfaces and 6 task types ranging from software-selection to open-ended tasks. We further introduce an artifact-centric evaluation methodology built on a unified domain-verifier suite, which programmatically checks the geometric validity, physical feasibility, and rule compliance of final and intermediate artifacts, and scores quantitative design tasks continuously by specification attainment rather than binary success. Evaluation of seven frontier models reveals a substantial capability gap: the strongest model achieves an EngiScore of only 44.3, and just 3.6% of multi-software attempts succeed. EngiWorld provides the first rigorous foundation for measuring progress toward agents that operate professional engineering software end to end.

Submission history

From: Yu Lei [view email]

[v1] Tue, 29 Sep 2026 14:32:35 UTC (8,071 KB)

Full-text links:

Access Paper:

View a PDF of the paper titled EngiWorld: What Can Frontier Agents Deliver in Professional Engineering Environments?, by Hongcheng Gao and 21 other authors

View PDF

HTML (experimental)

TeX Source

view license

Current browse context:

cs.AI

< prev | next >

new | recent | 2026-09

Change to browse by:

cs

cs.CL

References & Citations

NASA ADS

Google Scholar

Semantic Scholar

Loading...

BibTeX formatted citation

loading...

Data provided by:

Bookmark

Bibliographic Tools

Bibliographic and Citation Tools

Bibliographic Explorer Toggle

Bibliographic Explorer (What is the Explorer?)

Connected Papers Toggle

Connected Papers (What is Connected Papers?)

Litmaps Toggle

Litmaps (What is Litmaps?)

scite.ai Toggle

scite Smart Citations (What are Smart Citations?)

Code, Data, Media

Code, Data and Media Associated with this Article

alphaXiv Toggle

alphaXiv (What is alphaXiv?)

Links to Code Toggle

CatalyzeX Code Finder for Papers (What is CatalyzeX?)

DagsHub Toggle

DagsHub (What is DagsHub?)

GotitPub Toggle

Gotit.pub (What is GotitPub?)

Huggingface Toggle

Hugging Face (What is Huggingface?)

ScienceCast Toggle

ScienceCast (What is ScienceCast?)

Demos

Replicate Toggle

Replicate (What is Replicate?)

Spaces Toggle

Hugging Face Spaces (What is Spaces?)

Spaces Toggle

TXYZ.AI (What is TXYZ.AI?)

Related Papers

Recommenders and Search Tools

Link to Influence Flower

Influence Flower (What are Influence Flowers?)

Core recommender toggle

CORE Recommender (What is CORE?)

Author

Venue

Institution

Topic

About arXivLabs

arXivLabs: experimental projects with community collaborators

arXivLabs is a framework that allows collaborators to develop and share new arXiv features directly on our website.

Both individuals and organizations that work with arXivLabs have embraced and accepted our values of openness, community, excellence, and user data privacy. arXiv is committed to these values and only works with partners that adhere to them.

Have an idea for a project that will add value for arXiv's community? Learn more about arXivLabs.

Which authors of this paper are endorsers? | Disable MathJax (What is MathJax?)

参考来源: ArXiv AI
2026 in LLMs (so far) 配图

2026 in LLMs (so far)

核心内容
这篇文章回顾了2026年截至9月27日为止在大型语言模型(LLMs)领域的主要发展和趋势,特别强调了新模型的发布以及这些模型在编码代理方面的进步。
为什么重要
这篇文章的重要性在于它为读者提供了一个关于LLMs领域快速发展的概览,反映了技术进步对软件开发和人工智能领域的深远影响。它揭示了新技术如何改变日常工作和创新的可能性。
关键洞察
最有价值的观点是,Claude Opus 4.5和GPT-5.1这两个新模型通过改进其编码代理功能,使得模型在编码任务上的表现从“经常出错”转变为“足够可靠以供日常使用”。此外,文章提到的“Warelay”GitHub仓库的首次提交,预示了未来可能出现的新技术和应用。
潜在影响
这些技术进步将对软件开发者、企业以及整个技术行业产生深远影响。开发者能够更高效地完成编码任务,企业可能会利用这些工具加速软件开发流程,从而推动创新并提高生产效率。

27th September 2026

On Friday I gave the closing keynote at the WeAreDevelopers World Congress North America in San Jose. I tied together the key trends from the past year into a chronological exploration of everything that happened in 2026. The video is on YouTube; here are my annotated slides and notes to accompany the talk.

展开全文收起全文剩余 11 段 · 约 5 分钟

I’m going to give a lightning tour of everything that has happened so far in 2026. The year isn’t over yet!

For me, 2026 started a couple of months earlier in November 2025.

November saw the release of two important models: Claude Opus 4.5 and GPT-5.1. As is usually the case with new models, these were incremental improvements on the models that came before them. But every now and then when a model improves, it crosses an invisible line where something that didn’t really work starts working.

In this case, the thing that started working was their coding agents. Claude Code had been around since February 2025; Codex was a little younger. These two new models, when paired with their respective coding agent harnesses, improved from “often make mistakes” to “reliable enough to use on a day-to-day basis”.

For a couple of years now I’ve been evaluating new models by asking them to “Generate an SVG of a pelican riding a bicycle”. It’s probably the world’s stupidest benchmark—there’s only so much you can learn from it. But it’s still a challenge for models, because drawing pelicans is difficult, drawing bicycles is difficult, and pelicans can’t ride bicycles in the first place.

Here’s the state of the art for November. Claude still couldn’t really draw a bicycle! The GPT-5.1 bicycle frame is pretty crap too.

Also in November, we had the first commit to an obscure GitHub repository called “Warelay”. We’ll come back to this repository shortly.

And then there were the December holidays, and individual developers took some time off and many started tinkering with these new coding agent model combinations... and it began to dawn on us quite how much they could do that they couldn’t do before.

Come January, a lot of us were quite excited to start putting this stuff into action.

Every year I set myself a New Year’s resolution, and for as long as I can remember it’s been the same thing: stay focused. Take on less new projects. Try to get things done in the projects I already have.

This year I decided that since that had never worked before, I’d go the other way. We’ve got coding agents now, let’s see what they can do. I’m going to take on as many new projects as I like!

参考来源: Simon Willison
腾讯斥资70亿美元在东南亚采购算力服务 配图

腾讯斥资70亿美元在东南亚采购算力服务

核心内容
腾讯斥资70亿美元在东南亚向甲骨文采购算力服务,这一动作可能绕过美国的芯片出口管制,并可能加速美国推进“远程算力管制”立法。
为什么重要
这篇文章重要,因为它揭示了在当前国际政治经济背景下,大型科技公司如何应对严格的出口管制政策,并可能对全球半导体产业、国际法规以及企业运营策略产生深远影响。
关键洞察
1. 腾讯采购算力服务而非直接购买芯片,可能通过服务出口的方式规避美国的出口管制。 2. 美国的出口管制在服务出口方面存在模糊地带,客户对芯片的实际控制程度决定了是否构成“出口”。 3. 美国正在加速填补远程算力管控的漏洞,并可能通过立法来加强对远程访问受控物项的管制。 4. 腾讯被列入中国军事企业清单,其行动可能成为政治斗争的工具,推动相关立法进程。 5. 大规模交易可能率先触发监管打击,但同时也可能为其他算力企业提供缓冲。
潜在影响
此行动可能影响东南亚数据中心和算力服务市场,并可能加剧全球半导体产业链的重组。此外,美国可能进一步收紧出口管制,影响包括腾讯在内的多家企业,并可能引发更广泛的国际政治经济反应。

**腾讯斥资70亿美元在东南亚向甲骨文采购先进算力服务,可能绕过美国芯片出口管制,此举或加速美国推进“远程算力管制”立法,腾讯因被列入中国军事企业清单首当其冲。** **要点** **1. 采购模式为租用算力而非购买芯片** 腾讯向甲骨文采购约10万片先进GPU的算力服务,数据中心设在东南亚。由于美国出口管制只管辖“物项”(商品、软件、技术)而不直接约束“服务”,甲骨文自持芯片、远程租给腾讯使用,可能规避芯片出口禁令。 **2. 美国出口管制存在认定模糊地带** 是否构成“出口”取决于客户对芯片的实际控制程度。如果客户只是使用普通云服务,更倾向“服务”;如果客户能长期排他指定具体型号、配置和运行方式,则更接近物项“出口”。目前尚无明确结论。 **3. 美国立法正在加速填补远程算力漏洞** 2026年1月众议院通过《Remote Access Security Act》,拟授权商务部管制外国主体通过互联网远程访问受控物项的行为;同年6月参议院提出相应版本及NDAA修正案。但相关立法尚未正式生效。 **4. 腾讯的“中国军事企业”身份易成政治抓手** 腾讯被美国国防部列入1260H清单(中国军事企业),虽不直接限制民事交易,但该身份可能被美国鹰派用来推动“租用算力等于变相出口”的叙事,加速立法进程。 **5. 超大规模交易可能率先触发监管打击** 若BIS重新解释现有规则或国会加速立法,腾讯这类交易规模最大、最引人注目的案例将最先被制裁。文章指出,这反而为其他算力企业提供缓冲——天塌下来高个子顶着。

展开全文收起全文剩余 27 段 · 约 4 分钟

2026-10-01 21:19

敏大是一只柯基

速览

本文来自微信公众号: 敏大是一只柯基 ,作者:敏大的朋友们

据外媒报道,腾讯斥资70亿美元向甲骨文采购算力服务,数据中心设在东南亚,涉及约10万片先进芯片。

目前美国对先进芯片施加了严格的出口管制。达到特定性能参数的芯片,不仅不能随意出口到中国,即使运往东南亚等第三国,如果接收芯片的公司总部位于中国,或者其最终控股股东的总部位于中国,将同样受到严格限制。

AI模型训练广泛使用的H200、B200、B300等先进芯片,都在限制范围内。2026年5月31日,美国商务部工业与安全局(BIS)专门发布执法指引,重申了这一点。

但美国的出口管制规则有一个天然的缺口:美国出口管制只管“物项(item)”,包括商品(commodity)、软件(software)、技术(technology)。通常来说,服务(service)不在出口管制的管辖范围内,也就不受到前面所说的各种出口禁令的约束。

因此,这就产生了一个非常有意思的问题:

如果腾讯不是自己采购10万片芯片(按现有规则他们是买不到的),而是甲骨文或其他非中国第三方采购、持有并控制这些芯片,芯片从头到尾都留在数据中心,腾讯隔着互联网采购和使用甲骨文提供的算力——这到底算是在向腾讯出口芯片,还是只是在向腾讯提供一种服务?

目前还没有一个简单的答案。

传统的算力服务当然更像是服务,而不是物项的出口。但具体的认定和很多因素有关,比如中国客户究竟只是购买一个抽象的算力服务、还是可以指定具体型号和数量的GPU,能否长期排他使用某个GPU集群,能否直接决定硬件配置和运行方式,以及客户事实上对这些GPU拥有多大程度的控制。

越接近普通的云计算服务,越容易被理解为“服务”;越接近客户事实上长期、排他地控制一批特定芯片,则越接近物项的“出口”。

美国当然意识到了这个问题。2026年1月,美国众议院已经通过了《Remote Access Security Act》。这个法案想做的事情非常直接,修改美国《出口管制改革法》(ECRA),明确授权商务部对外国主体通过互联网、云计算等方式“远程访问”受出口管制物项的行为实施管制。

今年6月,参议院又出现了相应版本以及将相关内容纳入国防授权法案(NDAA)的修正案,开始进一步讨论通过客户身份、先进计算芯片集群规模和总算力等标准,划定远程算力的管制边界。

但需要注意的是,截至目前,这些讨论都还在立法阶段,没有正式生效。所以腾讯和甲骨文这则新闻的时间点就很微妙。目前中美关系相对平稳、美国行政部门未必希望马上发动一轮大规模的先进芯片出口管制升级。我们不知道是否是美国有人故意放出消息,“出口转内销”以推动国内的立法进程。

不论如何,它客观上给了美国国内鹰派提供了一个几乎完美的现实案例。他们不再需要向普通议员解释什么叫remote access、什么叫IaaS,只需要问一句:

如果美国法律不允许把10万片先进GPU卖给腾讯,为什么可以把10万片GPU放在东南亚,然后隔着互联网租给腾讯用?推动相关立法的美国议员已经使用过一个非常形象的说法:rent what they can’t buy。

腾讯还有一个很适合被美国政界拿来做文章的身份:腾讯被美国国防部列入Section 1260H所谓“中国军事企业”清单。1260H清单的制裁效果相对有限,主要是不能与美国国防部进行交易以及限制进入美国国防供应链,普通的民事交易和进出口不会受到1260H清单的直接影响。

但问题是,美国国防部是以所谓中国“军民融合”为政策背景建立这套名单的,腾讯的身份非常容易成为政治叙事工具。

因此,这个新闻真正值得关注的,不是腾讯到底能不能用这10万片芯片,而是美国会不会因为腾讯这样的超大规模交易,加速推进目前仍在讨论阶段的“远程算力管制”规则。

对其他经营算力中心的企业来说,这倒不完全是坏消息。如果BIS准备重新解释现有规则,或者国会准备加速立法,腾讯这种规模的交易大概率会首先中招。腾讯什么时候开始做不下去了,那才是真正值得警惕的信号。

这就叫,天塌下来高个子顶着。

AI创投日报频道: 前沿科技

本内容来源于网络 原文链接,观点仅代表作者本人,不代表虎嗅立场。

如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。

正在改变与想要改变世界的人,都在 虎嗅APP

参考来源: 虎嗅
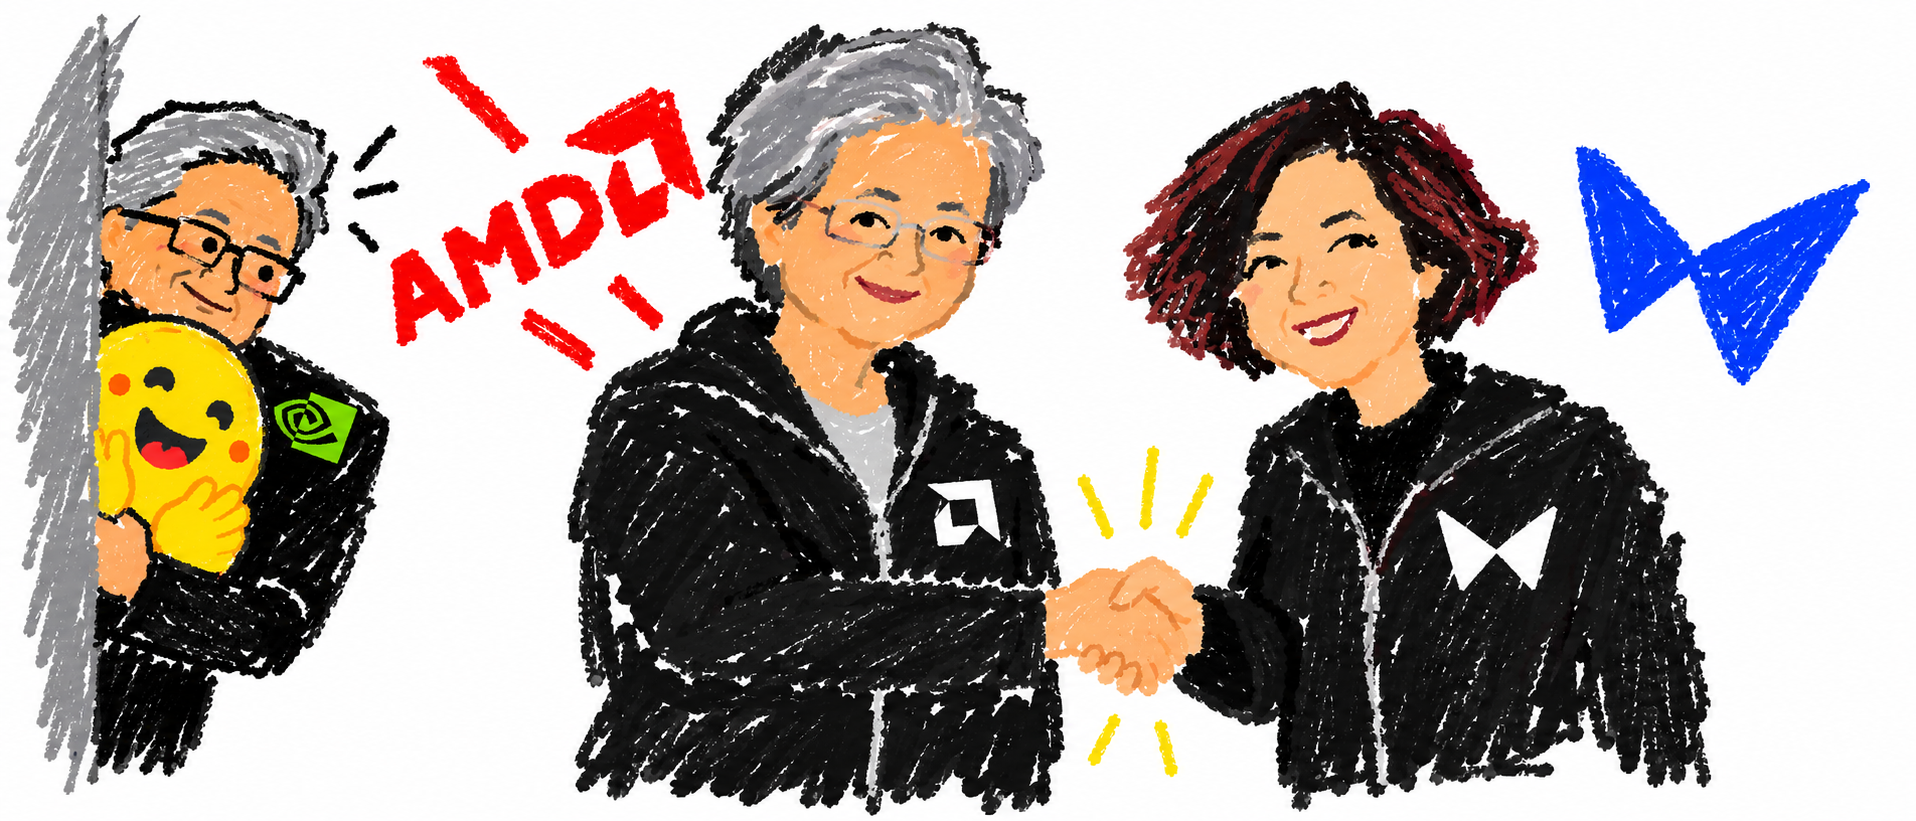
82 亿美元、全股票交易:AMD 收购 World Labs,李飞飞直接向苏姿丰汇报 配图

82 亿美元、全股票交易:AMD 收购 World Labs,李飞飞直接向苏姿丰汇报

核心内容
AMD 以82亿美元的全股票交易收购了李飞飞创办的World Labs,交易预计将在2026年底前完成,完成后World Labs将作为AMD的一部分继续AI模型研究,李飞飞将直接向AMD CEO苏姿丰汇报。
为什么重要
这个交易对于AMD和整个科技行业来说都具有重要意义。首先,AMD通过收购World Labs加强了自己在AI和前沿模型研究领域的布局,这有助于提升其技术创新能力和市场竞争力。其次,交易体现了AMD对李飞飞及其团队的信任和认可,这有助于吸引更多顶尖人才加入AMD,推动公司进一步发展。此外,这次收购还可能对整个AI领域的发展产生影响,推动更多企业和研究机构对AI模型研究的投入。
关键洞察
1. AMD通过收购World Labs加强了自己在AI和前沿模型研究领域的布局,这有助于提升其技术创新能力和市场竞争力。 2. 李飞飞及其团队在AI领域拥有丰富的经验和专业知识,加入AMD后,将为公司带来更多创新技术和项目。
潜在影响
1. 对AMD:增强技术创新能力,提升市场竞争力,吸引更多顶尖人才。 2. 对World Labs:作为AMD的一部分,将获得更多资源和支持,有助于加速AI模型研究的进展。 3. 对AI领域:推动更多企业和研究机构对AI模型研究的投入,促进整个AI行业的发展。

# 82 亿美元、全股票交易:AMD 收购 World Labs,李飞飞直接向苏姿丰汇报

9 月 29 日早间,AMD 宣布了一笔跨越芯片与前沿模型研究的交易:公司已与李飞飞创办的 World Labs 签署最终收购协议,交易作价约 82 亿美元,全部以 AMD 股票支付。交易预计在 2026 年底前完成,仍须获得监管批准并满足其他交割条件。换言之,双方已经签约,但收购尚未完成。

展开全文收起全文剩余 15 段 · 约 6 分钟

从 AMD 向美国证券交易委员会提交的文件看,交易协议于美国时间 9 月 26 日签署,AMD 于 9 月 28 日正式对外公布。收购对象的法律实体为 World Labs Technologies, Inc.,AMD 拟取得其全部股权,向 World Labs 股东支付约 82 亿美元的 AMD 普通股,最终金额仍受惯常调整条款影响。

这笔交易还有一个值得注意的细节:AMD 现在尚未确定需要发行多少股股票。根据其披露,发行股数将依据交割前连续 10 个交易日的 AMD 股票每日成交量加权平均价计算,这段计价期截至交割日前第二个交易日。因此,“82 亿美元”是目前披露的交易总价,不能直接按公告当天的股价算出最终发行股数。AMD 也表示,这些股份拟依据美国证券法相关豁免规定发行,并非面向公众的股票发售。

交易完成后,World Labs 将继续从事 AI 模型研究。其联合创始人兼 CEO 李飞飞将出任 AMD 执行副总裁兼首席科学家,直接向 AMD CEO 苏姿丰汇报。World Labs 另外两位联合创始人 Justin Johnson 和 Ben Mildenhall,也将与李飞飞一道继续领导团队。对于一家以 CPU、GPU 和计算系统为核心业务的公司来说,这意味着世界模型研究团队将进入其内部技术组织,而不只是继续作为外部客户或合作伙伴。

## World Labs 为什么加入 AMD?

World Labs 成立于 2024 年,研究方向是“空间智能”:让模型理解空间结构,并生成、重建和模拟三维世界。与主要输出文字或二维画面的模型相比,它试图建立能够保持空间关系、允许视角变化并供人或机器探索的环境。

在 AMD 宣布收购 World Labs 后,李飞飞发表长文回顾了自己从计算机视觉研究走向创业的经历,并解释了为何决定让 World Labs 加入 AMD。她将这次交易与一个持续多年的研究问题联系起来:如何让 AI 理解文字和图像之外的三维空间,以及物理世界中的行为。

李飞飞回忆,自己于 2000 年进入人工智能领域,最初关注的是机器与人脑的视觉智能。此后,她参与的 ImageNet 研究与神经网络在 GPU 上的应用一道,见证了现代 AI 的发展。她的研究和工作也逐渐延伸至深度学习、机器人和医疗等领域。随着前沿模型研究越来越多地从高校转向产业界,她认为,要持续攻克更大规模的技术问题,需要建立一家专注于此的公司。2024 年初,她与 Ben Mildenhall、Justin Johnson 共同创立 World Labs。

World Labs 的出发点是李飞飞在文中反复强调的一句话:“世界并非仅仅由文字构成。”在她看来,仅依赖语言不足以让模型理解现实世界。无论是科学研究、内容创作还是机器人,AI 都需要处理物体如何分布、空间如何连接,以及行动会带来什么结果。因此,World Labs 集合了计算机视觉、模型训练、系统和计算机图形学等领域的研究人员,尝试开发面向空间智能的基础模型。

李飞飞介绍,World Labs 成立以来已将研究用于图像、视频和三维空间重建,并通过收购 SceniX 将工作拓展至机器人仿真。她特别提到近期发布的 Atlas:这一模型尝试根据已有的二维图像预测从新角度观察场景时会看到什么,并将生成模型与多视角几何结合,用于稀疏图像输入下的三维重建。她认为,这类能力未来可用于设计、工程、房地产场景重建,以及机器人的训练环境。不过,关于模型性能和应用前景的判断,仍主要来自 World Labs 自身的研究展示。

谈及为何加入 AMD,李飞飞给出的理由是扩大研究规模,并让模型研发更接近硬件。她认为,如果缺少有针对性的硬件投入,世界模型在效率和规模上会受到限制,也更难从数字场景走向物理世界。随着合作推进,团队逐渐认为,将基础模型研究与 AMD 的硬件、软件和系统能力结合,是继续推进这一研究方向的路径。

她在文中表示,希望在 AMD 内继续推进开放模型和平台的研发,将研究范围贯通硬件、软件、模型与数据平台。World Labs 加入 AMD 后能否实现这些目标,仍有待后续研发和产品进展检验。

## 从投资、合作到收购

AMD 与 World Labs 的关系并非始于这份收购协议。今年 2 月,World Labs 宣布获得 10 亿美元新融资,投资者包括 AMD、英伟达、Autodesk 等公司。AMD 随后披露,旗下风投部门更早便参与了 World Labs 的 B 轮融资;双方还在 AMD Instinct GPU 上合作,涉及世界模型的训练和推理优化。这也解释了交易公告为何着重谈未来计算平台如何适应模型变化,而非仅强调 World Labs 现有产品能带来多少收入。

AMD 给出的判断是,AI 应用正在向推理、机器人、仿真和物理 AI 扩展,算力需求会随之变得更加多样。拥有直接开发这些模型的团队,可以帮助它更早看见训练和运行过程中的瓶颈,再把这些认识用于硬件、软件和系统路线图。这是 AMD 对交易目的的表述;模型研究最终能在多大程度上转化为产品优势,还需要看收购完成后的研发和部署结果。

这笔交易因此有两层含义。一层是人才与技术:AMD 将获得一个已推出世界模型产品、并进入机器人仿真领域的研究团队。另一层是研发方式:当芯片厂商要为尚在快速变化的模型设计计算基础设施时,直接参与模型研发,可能比仅从客户那里接收需求更早发现问题。后一点是基于双方公告和既有合作作出的判断,并非已被交易证明的商业成果。

参考来源: InfoQ推荐
苏姿丰550亿元买下李飞飞世界模型,AI 圈两位女王联手了 配图

苏姿丰550亿元买下李飞飞世界模型,AI 圈两位女王联手了

核心内容
文章主要讲述了芯片巨头AMD以约82亿美元的全股票方式收购AI独角兽World Labs,并由李飞飞创立的这家公司加入AMD,李飞飞本人也将加入AMD担任执行副总裁兼首席科学家。
为什么重要
这个内容值得关注,因为它标志着AMD在AI领域的重大投资和布局,反映了AI技术在芯片行业的重要性日益凸显,以及AMD对AI技术的重视和战略规划。
关键洞察
最有价值的观点是李飞飞对AI空间智能的研究方向和成果的阐述。她提出AI需要理解真实世界,而不仅仅是处理文字,这需要AI具备空间智能。World Labs开发的Atlas模型在稀疏重建等计算机视觉领域的任务上取得了进展,这表明AI在理解真实世界方面有了新的突破。
潜在影响
这一收购可能对AMD在AI领域的竞争力产生重大影响,AMD将能够利用World Labs的技术和人才,加速其在AI芯片和解决方案方面的研发。同时,这也可能推动整个AI领域的发展,促进AI技术与芯片技术的深度融合。

就在刚刚,芯片巨头 AMD 正式官宣,将收购李飞飞创立仅两年的 AI 独角兽 World Labs。AI 圈的两位硅谷华裔女王,正式完成了历史性的「双向奔赴」。

本次交易将以全股票方式进行,作价约 82 亿美元。目前双方已经签署最终协议,预计在 2026 年底前完成交易,但仍须获得监管批准并满足其他常规交割条件。

展开全文收起全文剩余 17 段 · 约 5 分钟

交易完成后,李飞飞将出任 AMD 执行副总裁兼首席科学家,直接向 CEO 苏姿丰汇报;World Labs 另外两位联合创始人 Justin Johnson 和 Ben Mildenhall 也将继续带领团队,推进模型研究。

要理解 AMD 为什么愿意花 82 亿美元,就得先看看 World Labs 究竟在研究什么。

在官宣长文中,李飞飞引用了诗人丁尼生《尤利西斯》中的名句:「来吧,我的朋友,去探寻一个更新的世界,现在尚不算晚。」对于她来说,这个「新世界」指向一个问题:AI 已经很擅长处理语言,但它能否理解语言所描述的真实世界?

李飞飞在文章中写道:「宇宙不是由文字组成的,而是由真实事物组成的。」科学研究、娱乐创作和机器人行动,都要求模型理解物体的位置、空间的结构,以及环境会如何随着视角或动作变化。只会处理文字,显然不足以完成所有这些任务。

为此,李飞飞在 2024 年初与两位 AI 研究员 Ben Mildenhall、Justin Johnson 共同创办 World Labs,把研究方向放在「空间智能」(Spatial Intelligence)上。这支目前约 70 人的团队,汇集了数据、计算机视觉、大模型训练、系统架构和计算机图形学领域的研究人员。今年 7 月,World Labs 还收购了 SceniX,将机器人仿真能力纳入自己的研究版图。

AMD 在最新公告中进一步说明,World Labs 正在开发能够根据文本、图像和视频输入,生成、重建并模拟可交互三维环境的空间智能模型,同时研究机器人学习与仿真技术。

近期发布的 Atlas,是 World Labs 展示研究进展的一项成果。大语言模型通过前面的文字预测下一个 Token,Atlas 处理的问题则是:给定二维图像,如果把摄像机移到另一个位置,那里应该看到什么?

按照李飞飞的介绍,Atlas 从头训练,结合生成式模型与多视图几何,根据有限的输入图像预测新的观察视角。她称,Atlas 在相关任务上的表现超过了一些专用模型,并在长期困扰计算机视觉领域的「稀疏重建」问题上取得进展。所谓稀疏重建,可以简单理解为:手里只有少量照片,却希望推断出照片没有拍到的空间。Atlas 要解决的正是这一类问题,当然,能够预测新视角,并不意味着模型已经掌握了真实世界的全部物理规律。

技术的应用场景已经浮现。李飞飞提到,机器人强化学习可以使用生成的环境进行训练;治疗和娱乐领域可以用它创建场景;房地产、设计和建筑行业,则可能用它重建真实空间。World Labs 收购 SceniX,也让从三维场景生成走向机器人仿真的路线更加清晰。

AMD 买下的,既有 World Labs 现阶段的模型成果,也有一支持续研究 AI 如何理解空间和物理世界的团队。

技术方向明确,创始团队也颇具分量,李飞飞为什么在公司成立两年多后选择加入 AMD?

在官宣长文中,她回顾了自己的职业生涯。从 2000 年作为研究生进入 AI 领域,到主持 ImageNet 项目,推动计算机视觉研究;从担任谷歌云 AI 部门的首席科学家,到成为斯坦福大学以人为本人工智能研究院的创始院长,她始终希望让 AI 参与解决现实世界的问题。创办 World Labs,是她在生成式 AI 时代继续追求这一目标的选择。但随着研究深入,模型规模、计算效率和硬件适配,逐渐成为必须解决的问题。

「要加速进入这个未来,需要扩大我们的工作规模、扩大影响范围,并更贴近硬件。」李飞飞在文章中写道,如果缺少有针对性的硬件支持,AI 的效率与规模都会受到限制,她希望发展的空间智能也难以走出数字环境。

AMD 与 World Labs 的合作并非从这次收购才开始。李飞飞称,苏姿丰是 World Labs 的早期投资者,也是她多年的朋友。过去一年,两家公司围绕 AMD GPU,深入开展了模型训练与推理优化。

合作越深,双方越能看到彼此的需求。World Labs 需要算力和工程资源,才能扩大前沿模型研究;AMD 则需要了解新模型如何运行、消耗哪些资源,以及未来的硬件该为哪些任务做准备。AMD 在收购公告中明确提到,随着 AI 进入推理、机器人、仿真和物理 AI 领域,计算基础设施面对的需求正在变得更加多样。World Labs 的模型研究经验,可以帮助 AMD 观察这些工作负载的变化,并影响未来的技术路线。换句话说,AMD 希望研究人员在提出计算需求时,硬件团队就在同一张桌子旁。

正如李飞飞在接受外媒采访时所说,加入 AMD,将为 World Labs、AMD 及整个生态提供一个机会,加快软件与硬件的共同开发。交易完成后,World Labs 团队将继续专注于模型研究,而李飞飞也会直接参与 AMD 的技术领导工作。

药物发现、创意生产、学习方式和下一代机器人,是李飞飞列举的长期目标。眼下更具体的任务,则是让空间智能研究获得足够的计算和工程支持。

参考来源: 爱范儿
✨ AI 助手