第 10 期 · 2026-W39 2026年09月20日 — 09月27日
✦ 本周速览

本周我们将目光投向AI的"动手"时刻:从Claude发现带有CRISPR样重复序列的全新酶系统,到模拟代码执行环境下对LLM的新越狱手法,再到Claude Opus 5.5以更低成本实现Fable 5.1级别性能,技术与安全的博弈依旧火热。其中最不容错过的当属头条《扎克伯格谈Muse》——听小扎亲自聊聊这款引发热议的产品,或许能一窥Meta的下一步棋。泡杯咖啡,慢慢读吧。

扎克伯格谈Muse 配图
头 条

扎克伯格谈Muse

核心内容
扎克伯格在访谈中阐述了Meta新推出的个人AI助手Muse的产品理念:上线两周即登顶美国下载榜首(超250万次下载),其核心设计哲学是从预训练阶段就专为个人Agent打造模型,并依托云端虚拟机、记忆系统和逐项权限授权构成完整技术栈。同时他还透露了Meta在Llama 4失利后重建模型研发团队(小团队+大算力,新模型"Watermelon"即将发布)以及Muse"免费额度+交易抽成"的商业模式。
为什么重要
这篇文章揭示了AI竞争正在从"通用模型能力"转向"个人Agent全栈架构"的新阶段,Meta以基础设施级设计(虚拟机、机密计算、权限系统)定义了下一代AI产品的竞争门槛,并提出了通过技术扩散实现AI安全的战略主张,反映了头部科技公司在AI产品化路径上的关键分野。
关键洞察
最有价值的观点是扎克伯格提出的"个人Agent必须从预训练开始设计"——通用模型的后训练无法解决理解用户长期目标和隐私边界判断的问题;同时Meta计划通过机密虚拟机从架构上保证连自身都无法读取用户数据,这是将隐私保护从政策承诺升级为技术约束的重要信号。商业模式上,每周1亿token免费额度加交易抽成的设计,显示Meta意在以补贴换取Agent经济的生态入口。
潜在影响
个人AI助手用户、Meta的竞争对手(OpenAI、Google等)以及依赖AI Agent交易的商家都将受到影响——Agent可能成为新的流量与交易入口,改变用户获取服务和消费的方式,而"从预训练设计Agent"的范式也可能推动行业重新审视模型研发的产品导向。

**Muse上线两周即登顶美国应用下载榜首,累计下载超250万次。扎克伯格称个人Agent必须从预训练开始设计,虚拟机、记忆与权限系统构成全栈护城河,并主张通过技术扩散形成安全制衡。** **要点** **1. Muse从预训练而非后训练设计** 扎克伯格认为,理解用户长期目标、判断信息使用边界不能靠给现成模型加界面,必须从预训练阶段就将个人Agent需求纳入模型设计。 **2. 虚拟机与记忆系统支撑持续行动** Muse配备云端虚拟机,可在后台操作计算机、登录服务并全天候执行任务;夜间整理反思写入记忆,还能主动建议新项目,从单次工具变为长期服务。 **3. 逐项授权与机密虚拟机保护隐私** 登录、付款、发送敏感信息需用户批准,遵循最小权限原则;Meta计划通过机密虚拟机和安全凭据存储,从架构上保证即使自身也无法读取用户内容。 **4. 提供免费额度并靠交易抽成盈利** Meta每周提供1亿token和一台虚拟机的免费额度,相信Muse帮用户省钱、赚钱后能抵消成本;长期可能从用户与商家交易中收取小额费用,目标是让多数人免费使用。 **5. Meta重建模型研究:小团队+大算力追赶前沿** Llama 4偏离预期后,扎克伯格转向更精简的核心研究团队,增加算力投资,俄亥俄州吉瓦级集群已上线。新模型“Watermelon”即将发布,规模更大、预训练水平显著提升。

展开全文收起全文剩余 86 段 · 约 22 分钟

2026-09-25 16:55

Z Finance©

速览

本文来自微信公众号:Z Finance,作者:ZF编辑部,编译:Shiny GU,原文标题:《深度|扎克伯格谈Muse:个人Agent必须从预训练开始设计,虚拟机、记忆和权限系统是巨头的全栈护城河》,题图来自:视觉中国

Muse上线后,Meta久违地拥有了一款迅速出圈的AI产品。不到两周,它登上美国应用下载榜首。据Sensor Tower统计,截至9月22日,累计下载量已超过250万次。

为了让Agent真正替人行动,Meta给它配置了云端虚拟机。为了让用户敢把邮件、账户和私人信息交给它,又必须设计记忆、凭据存储和逐项授权的权限系统。扎克伯格认为,这些能力不能靠给现成模型增加一个产品界面完成;模型从预训练开始,就要学会理解个人目标,判断哪些信息可以使用、哪些不能向外披露。

这也是Muse背后更深的一场竞争。Meta首席执行官扎克伯格在与科技记者Alex Heath的对话中,谈到了这套产品设计,也谈及Llama 4失利后Meta如何重建模型研发,以及他为什么主张让更多人拥有强大的AI。访谈的主要观点包括:

1. 个人Agent要从预训练开始设计。扎克伯格认为,理解用户的长期目标,以及判断私人信息的使用边界,不能只靠通用模型的后训练来解决。

2. 虚拟机让Agent具备持续行动的能力。Muse可以在后台操作计算机、登录服务,并围绕用户的目标推进任务。

3. 记忆让Agent从单次工具变成长期服务。它会根据已完成的任务和用户反馈调整后续行动,也可以主动提出新的项目。

4. 权限决定用户敢把多少事交给AI。登录、付款、发送邮件和披露敏感信息需要明确授权;Agent只能获得完成当前任务所需的权限。

5. 隐私保护要写进系统架构。Meta计划通过机密虚拟机和独立的凭据存储,减少公司及核心Agent接触用户敏感信息的机会。

6. 免费额度是扩大用户规模的起点。扎克伯格希望Muse通过帮用户省钱、赚钱和经营业务,逐步证明个人Agent的经济价值。

7. Meta正用新的方式追赶前沿模型。在Llama 4偏离预期后,扎克伯格转向更精简的核心研究团队,并继续增加算力投入。

8. 技术扩散也是扎克伯格的安全主张。他认为,强大AI若只由少数机构掌握,同样会带来风险;让更多人获得能力,才能形成制衡。

AI的安全不能只靠限制访问,关键是让更多人拥有制衡能力

Alex Heath:我们上次通话是在一个周末,你当时还通过智能眼镜给我打电话。那次你想谈刚发表的一篇长文,其中提出了很多关于AI未来的主张。为什么要写这样一篇近似宣言的文章?

Mark Zuckerberg:如果一家机构要在AI上投入这么多,就有责任说明自己的研究团队相信什么,以及这些工作为什么能够导向一个积极的未来。AI既带来巨大机会,也存在真实风险,所有参与者都应该形成一套经过认真思考的理论。

我强烈反对一些在行业内被视为理所当然的观点。在我看来,更积极的未来来自尽可能广泛地分发技术。这一判断建立在三点之上:第一,赋予个人更多能力,一直是人类繁荣的重要来源;第二,AI的首要用途将是创造新事物,而不是将现有工作自动化;第三,未来安全的基础应是适当的权力制衡,而不是限制使用权。

很多人的直觉是,技术越强,就越应该只让少数人接触。我更担心的是,只有少数研究机构或个人控制如此强大的能力。历史上,很多重要进步并非来自既有权力中心,而是来自边缘位置、最初不被认真对待的人。当他们获得足够好的工具,可以证明自己的想法时,才有机会推动真正的变化。

网络安全也是如此。如果有人拥有能够攻击系统的AI,最有效的应对方式之一,是让更多机构也拥有AI,以便提前加固自己的系统。开源软件之所以常常更安全,正是因为更多人能够查看、检验和修正它。把技术交到更多人手里,看似会增加风险,却也可能形成更稳定的制衡。

Meta会开发领先模型,也会发布一部分开放模型,但这不意味着所有成果都必须开源。营利性公司可以保留一部分先进技术。关键是维持强健的开源生态,让市场保持竞争,也让外界能够理解技术的发展方向。以Hugging Face遭遇入侵的事件为例,他们发现入侵后转而使用开源模型,因为他们无法获得某些与这次问题有关的闭源模型。这说明世界上需要保护的重要机构远不止排名最靠前的一百家。

不过,比开源本身更重要的,是让普通人真正用上技术。Muse体现的就是这一思路:给每个人一个能力很强的个人AI Agent,让它理解用户的目标,并且每天24小时持续代表用户工作。

Alex Heath:AI和数据中心正在受到越来越强烈的抵触。你的意思是不是,如果更多人能够得到目前集中在少数研究机构手中的能力,他们就不会再觉得自己被排除在AI进程之外?

Mark Zuckerberg:问题不能只停留在抽象层面。人们担心就业和经济,也担心数据中心对社区与环境的影响;还有网络攻击、生物安全、自由社会、美国的技术领导力,以及当AI越来越强时,人类如何继续控制它。每一类问题都有不同细节,但它们有一个共同点:技术带来的繁荣必须广泛分布,能力也不能只掌握在少数内部参与者手中。

Meta进入一个地区建设数据中心,实际上是在承诺未来几十年持续投资。这样的长期投入可以为社区带来税收、就业和其他资源。比如在路易斯安那州,相关税收曾为当地教师提供每人5万美元的奖金。市场上也有另一类项目:有些公司只想先拿下一块地,再卖给大型AI研究机构。

它们并不打算长期运营,也没有动力认真处理与当地社区的关系。我不确定是否该把这种现象称为泡沫,因为“泡沫”意味着估值过高。但这个领域确实正在经历一轮热潮,也因此容易滋生短期逐利的行为。如果项目只顾眼前交易,社区反对并不奇怪。AI基础设施如果不能创造就业、扩大社会整体繁荣,也不能让当地社区受益,就不可能无限扩张。因此,让利益广泛分布不是附加条件,而是行业能够持续发展的前提。技术要可行,社会层面也必须可行。

Meta推出了America's Workforce Academy,原因很实际:建设数据中心需要大量光纤技术人员、电工、高级木工等技术工人,而市场上远远不够。未来可能还需要数十万甚至数百万人。我们保证,完成培训的人能够在参与Meta基础设施建设的单位找到工作。这不是单纯的慈善,而是长期利益一致:Meta需要熟练工人,参与者需要新的职业机会。若企业只是建设一个项目后转手,就不会进行这种投入。

Muse不只回答问题,还要围绕用户的长期目标持续执行任务

Alex Heath:你大约一年前开始谈“个人超级智能”。当时很多人想知道,你究竟看到了什么。现在看来,答案就是Muse。为什么你认为它会成为Meta的下一阶段?

Mark Zuckerberg:我们从未只把Meta看成一家社交媒体公司。公司的长期主题是连接人与赋予个人能力。过去围绕内容管理发生的很多争论,实质上也在讨论:人们能不能自己决定什么对生活重要,并按照自己的判断交流。

这段经历强化了我的一个认识:历史上的许多进步,都来自个人获得更多能力,而且人们最清楚自己的生活需要什么。因此,每当有人说应该由少数专家决定AI去解决哪些大问题,我都会本能地保持警惕。人们当然关心健康和生活质量,但也关心家人、朋友、关系和文化。对科学家或工程师而言不够宏大的问题,对某个人可能极其重要。

即使在健康领域,个人关注的重点也可能与行业不同。制药和生物技术行业目前主要关注常见疾病,但还有大量不同的罕见疾病和健康问题,相关投入明显不足。如果你患有某种罕见病,自然会希望自己的AI关注它,而不是仅仅因为另一种病更常见,就把资源用在别处。

Alex Heath:你也通过自己的基金会在这方面投入了很多。

Mark Zuckerberg:我们正在通过Biohub开展这方面的工作,这些经历也在一定程度上影响了我的看法。我认为,人们应该有能力自己决定什么最重要。对我来说,Muse也不只处理宏大任务。我希望它帮助我成为更好的父亲、丈夫和朋友。我的三岁女儿喜欢烘焙,但我对此一无所知。

我让Muse每个周末准备一个适合三岁孩子、也适合不会烘焙的成年人完成的项目,并通过Instacart备齐原料。做完后,我再告诉它哪些步骤太难,它会据此调整下一次安排。事实证明,蛋糕棒并不适合作为入门项目。我的大女儿喜欢登山,有些路线需要抢许可证。Muse会等待开放时间并替我申请,拿到后告诉我具体日期,我再安排休假陪她去。

它也会关注我的训练。我在综合格斗训练室安装了摄像头,让Muse分析视频并提出意见,有时它会很直白地指出我在哪个动作中明显放弃了。早期测试者的使用方式差异很大。有人拿到Muse后,不到一天就开始用它协助安排孩子的居家教育;有人在12小时内用它规划完整旅行;还有一位原本对科技很怀疑的测试者,几天后最关心的问题却是正式发布时能不能保留已经了解她的Muse。

Muse与Meta AI、ChatGPT或Gemini式的一问一答不同。用户交给它的不是单个提示词,而是一个项目或长期目标。后台的虚拟机让它能够操作计算机、登录服务并持续执行任务;它会围绕这些目标全天候持续工作,直到帮助用户实现目标。夜间,它还会整理当天的反思并写入记忆,也能够主动建议新的项目。

例如,我让它为我和女儿玩的《文明》制作攻略。完成后,它又建议把攻略扩展成讲解不同文明历史的学习材料,并直接在应用里增加了一个页面。许多人不知道应该怎样使用AI;如果AI Agent能够主动提出对用户有帮助的事情,就能降低这道门槛。

Alex Heath:你认为它真的能替用户赚钱?

Mark Zuckerberg:能。用户可以选择付费订阅,但Meta一开始也会提供每周1亿token和一台虚拟机的免费额度。我们的判断是,当个人用它经营小企业、完成商业任务或参与交易时,它创造和节省的价值足以覆盖成本。

长期来看,我们预计可以从相关交易中收取很小比例的费用,而且不一定由用户支付,也可以由与用户开展交易的商家承担。我们希望绝大多数人都能免费使用这项服务。要让每个人都拥有强大的个人AI Agent,首先就得让他们用得起。因此,我们愿意先提供大量免费用量,因为我们相信,它能帮用户赚钱、帮用户省钱,从而抵消使用它的成本。

我们正在与Stripe合作,为Muse接入支付功能。你可以选择把Muse连接到需要的服务,包括Meta的服务,但不愿意连接也完全可以。如果用它经营业务,你可以授权它接入我们的广告系统,让它协助制作产品、运营业务,并把这些工作串联起来,全天候持续执行。Meta目前大约每月发布一次重要模型更新,因此Muse的能力也会随之提高。

Alex Heath:团队还提到,不同用户的Muse可以从其他Agent积累的匿名化经验中学习。这种学习机制带来的网络效应,会不会成为Meta的核心优势?

Mark Zuckerberg:行业目前大多把AI Agent当成单人产品,但多个Agent之间还会出现很多新的协作方式。这类能力大多不会随当前版本推出,但从长远看,随着你认识的人越来越多地使用Muse,它就能通过Agent之间的互动,为你提供更好的体验。Meta还有几项不同优势。我们从底层设计模型,让它适合个人AI Agent;我们也有很强的社交产品经验,会更重视它如何帮助人改善关系。

网络效应固然重要,但市场不会只有一种需求。帮助用户经营小企业的最佳Agent,未必也是处理人际关系最好的Agent。具备足够技术实力、能在个人AI Agent领域做到最先进水平的公司,可能不会超过十二家。不过,不同公司仍然可以在不同用途上做到最好。Meta擅长把经过验证的消费产品推广给数亿乃至数十亿用户。Muse和Meta AI目前侧重点不同:Muse更倾向于从一句话中理解用户的长期意图,并继续推进任务;Meta AI更适合立即回答一个明确问题。两者未来是否会合并,现在还不能确定。

为了让用户放心接入私人信息,Meta如何设计Muse的隐私与权限保护

Mark Zuckerberg:个人AI Agent要真正有用,不只需要前沿能力,还必须充分理解用户。人们可能会把邮件、消息、广告账户、健康信息和其他私人资料接入Muse;只有对系统有很高信任,用户才会这样做。

Meta过去十多年建设WhatsApp端到端加密系统,最重要的经验是:系统可以被设计成连Meta也无法读取用户消息。这既降低政府或黑客获取内容的风险,也防止Meta内部人员滥用信息。我们邀请Signal创始人Moxie Marlinspike加入团队。他在2014年曾协助建设WhatsApp加密,这次专门负责Muse的机密虚拟机。

我们的目标是让用户把信息保存在云端的个人虚拟机中,并通过技术手段保证,连Meta也无法读取其中的内容,而且这一承诺可以被技术验证。随着这项功能准备向更多用户开放,我们会在未来几周公布更多细节。在它准备就绪之前,以及对于不选择使用它的用户,Muse也会提供其他安全保护措施。

一种最直接的隐私方案,是让每个人买一台Mac Studio,把Agent放在家里运行。但不可能有数十亿人购买设备、安装软件并自行维护。Muse希望提供一种任何技术水平的家庭成员都能直接使用的服务:它像本地机器一样私密,却可以在云端自动开通和运行。

机密虚拟机并不是全部。Muse还设有安全凭据存储系统,用来保存信用卡信息、密码和一次性卡号,避免这些敏感信息直接暴露给核心Agent;当用户要求它登录或付款时,Agent只能在必要时调用这些凭据。系统还运行一组监控Agent,检查进入和离开虚拟机的流量。它们会识别提示词注入,判断Muse是否准备把用户可能不愿公开的信息传出去,并在必要时触发人工确认。

登录、付款和传递敏感信息通常都需要用户批准。用户可以把某一类操作设为长期允许,但Muse不能自行扩大权限。连接邮箱时同样遵循“最小权限”原则。如果用户希望它发送邮件,就应针对这项操作明确授权,而不是一接入邮箱就让它获得全部权限。每一步只获得完成当前任务所需的最低权限,而不是一次授权全部能力。

这些设计也是Meta认为自己能在个人AI Agent市场形成差异的原因。个人Agent不仅要了解用户,还要具备分寸感。例如,它知道你怀孕了,预订餐厅时就可以帮你寻找提供优质无酒精鸡尾酒的地方,但不必向餐厅解释你怀孕了。它需要在不反复询问你的情况下,判断哪些信息属于敏感内容,既帮你实现目标,也避免透露不必要的个人信息。

在我看来,要做好这类能力,不能只是拿一个现成模型稍作后训练,而要从一开始就围绕个人Agent的需求设计模型,并把相关数据纳入预训练。就像做好Instagram信息流,需要同时建设应用、基础设施、机器学习系统和芯片一样,这是一项需要各个环节共同配合的工作。

Llama 4偏离预期后,Meta用更小的核心团队和更大算力重建AI研究

Alex Heath:SemiAnalysis在7月的一篇文章中认为,Meta最有可能追上OpenAI和Anthropic,衡量Meta Superintelligence Labs时应该看进步速度,而不只是当前起点。Artificial Analysis最近的图表也显示Muse Spark进展很快。你去年重建研究团队后,内部究竟发生了什么?

Mark Zuckerberg:Meta长期以来就在机器学习领域领先。Facebook和Instagram的信息流、广告系统,以及识别和处理不适宜内容的安全系统,本质上都是大规模机器学习系统。大语言模型兴起后,FAIR完成了Llama的早期研究,但我们还需要把研究转化为工业化流程,并按照规模定律扩大模型。

我当时犯的错误,是以为Meta既然擅长其他机器学习系统,开发和扩展大语言模型的方法也会相似。实际上,两者的运行规律有很大差别。Llama 3是一个不错的模型,但Llama 4发布时已经偏离我们需要的进步轨迹,这意味着必须改变方法。

我由此更重视人才密度。前沿模型研究并不是让一千个人各自运行实验就能解决的问题。更理想的状态,是由一支规模尽可能小、成员能够在头脑中把握整个系统的顶尖团队,围绕同一个科研项目紧密协作。当团队席位有限时,每一个位置都必须尽量找到最好的人。

因此,我投入了大量个人时间招聘,也让自己在技术上更接近一线工作,以便真正理解问题并指导公司。研究团队就设在我办公室周围。随着研究质量提高,我们也显著增加算力投资,正在建设数吉瓦规模的基础设施。Meta拥有几十年的数据中心经验,也有盈利能力支撑这种长期投入。

过去一年,Meta重新启动研究计划,位于俄亥俄州的吉瓦级Prometheus集群已经上线,并开始用于扩展“Watermelon”之后的模型。Watermelon也即将发布。它的规模更大,预训练水平也有显著提升,我们还会继续把在后训练中积累的经验应用到它上面。

此前发布的Muse Spark 1.3,则来自内部代号为Avocado的一次相对较小规模的预训练。Meta不会满足于跟在前沿之后。我们是一家端到端技术公司,即使过去主要建设社交应用,也从未只做应用层,而是同时建设数据中心、芯片和基础设施。

未来体验中最关键的部分会是模型,因此我们必须自己站在前沿。模型能力不是一个单一榜单。编码等能力具有普遍价值,因为许多个人AI Agent任务最终都要生成软件:Muse分析综合格斗视频的流程是一个编码项目,替用户制作可以投屏的《危险边缘》游戏也是如此。

但Meta也会重点研究其他机构未必同等重视的能力,例如个人Agent在与外界交互时,如何判断哪些信息可以使用、哪些不能披露。我们也非常重视编码能力和递归改进,因为后者对持续保持前沿水平很重要。因此,我们的研究方向有一部分与其他实验室重合,也有一些不同的侧重点。

从模型安全到智能眼镜和青少年保护,技术扩散必须与明确边界同行

Alex Heath:如果未来模型出现你认为不安全的能力,Meta会不会也选择暂缓发布?

Mark Zuckerberg:安全首先应当进入设计和训练过程。目前,各家研究机构都在遇到模型钻奖励机制空子的问题,也就是reward hacking:模型得到一道编程任务后,已经聪明到会先理解整个运行环境。有时它发现,修改虚拟机配置比真正解决程序问题更容易,于是通过改变环境获得奖励,却没有学到训练者希望它掌握的能力。

Alex Heath:听起来,你们不是这样训练模型的?你不认同这种训练方式吗?

Mark Zuckerberg:不是,我认为大家基本都采用这种训练方式。我的意思是,需要在训练过程中设立清楚而坚定的边界。这在一定程度上像教育孩子,但这个类比也不能过度延伸。安全边界如果太弱,模型就会钻空子;边界足够明确,既能让它学习课程本身,也能逐渐形成更合适的行为方式。训练结束后,还要回答强大模型怎样对社会产生积极影响。

我仍然认为,应该让更多人分享机会,并用广泛分布的权力形成制衡。若只有一个人拥有超级智能律师,他可能赢得本不该赢的诉讼;如果每个人都有同样强的法律工具,低质量论点就更难蒙混过关,司法过程反而可能更高效、更公平。

Alex Heath:政府应该扮演什么角色?

Mark Zuckerberg:AI变化太快,固定规则很容易滞后。更有效的做法,是让企业与监管方保持足够透明的沟通,让外部了解重要训练任务和即将出现的能力,并提前准备网络安全、生物安全等不同风险。对我来说,关键不是设计一套很快过时的流程,而是建立持续的知识交流和可信对话。

Alex Heath:Meta智能眼镜正在进入主流,同时也出现了“它会被拿来偷拍”的担忧。一些场所甚至禁止佩戴。你怎么看?

Mark Zuckerberg:我们从第一代产品开始就把隐私要求写进设计:只要摄像头录像,镜框上的指示灯就会明显闪烁;如果用户试图破坏指示灯,系统更新会直接让摄像头失效。手机录像并没有这样的提示灯,从这一点看,眼镜反而更透明。

问题在于,产品刚发布时Meta解释过这些措施,但当时用户很少。如今已有数百万人使用,许多人没有听过早期说明。我们后来更多强调外观、款式和功能,却没有持续解释隐私设计。社交媒体的发展也给了我一个教训:仅仅看到人们继续使用产品,并不等于他们理解公司怎样处理风险。如果更早、更直接地说明这些问题,公众今天对社交媒体的看法或许会不同。

Alex Heath:这与Meta最近就青少年安全问题达成的和解有没有关联?

Mark Zuckerberg:Meta很早就在Instagram推进青少年账户保护。和解的重要目标,是为整个行业建立共同标准。比如,把青少年每天使用时间限制在一小时,单家公司原则上可以接受;但如果Instagram单方面限制,而用户随后把同样时间转移到TikTok,就没有真正改善青少年处境,只是让一家公司的竞争位置受损。

Meta希望推动统一的青少年保护行业标准,例如围绕使用时长、通知、上课和睡眠时间设置限制。这样可以避免单一平台率先自律却让用户转移到其他平台,也能让各家公司在一致框架下共同保护青少年。

原视频:Mark Zuckerberg on how Meta's Muse AI agent will make people money

https://www.youtube.com/watch?v=Lx8lrn-cytc

本文来自微信公众号:Z Finance,作者:ZF编辑部,编译:Shiny GU

AI行业信号频道: 前沿科技

本内容由作者授权发布,观点仅代表作者本人,不代表虎嗅立场。

如对本稿件有异议或投诉,请联系 tougao@huxiu.com。

正在改变与想要改变世界的人,都在 虎嗅APP
参考来源: 虎嗅
AI

BreakFun: Jailbreaking LLMs via Object Instantiation under Simulated Code Execution

核心内容
该论文提出了一种名为 BreakFun 的新型越狱攻击方法:攻击者构造一个看似无害的 Python 类定义("Trojan Schema",木马模式),其中恶意字段名会引导模型在模拟代码执行时"实例化"出有害内容——有害信息以模拟执行的副产物形式出现,而非直接请求。该方法在 JailbreakBench 上对 13 个开源和商业模型实现了平均 89% 的攻击成功率,并提出了名为"对抗性提示解构"(APD)的检测对策。
为什么重要
这篇文章揭示了一个此前被忽视的安全盲区:LLM 的代码理解能力本身就是攻击面,安全机制通常只审查用户"直接请求"的内容,却忽略了模拟任务"间接产生"的副作用内容。这反映出当前对齐和安全过滤机制在语义层面的根本性局限,对依赖 LLM 的各类应用(尤其是接入代码能力的 Agent 系统)构成系统性风险。
关键洞察
最核心的发现是:开源模型几乎完全失守(约 98% 成功率),商业 API 系统也达 78%,且消融实验表明 "Trojan Schema" 是攻击成功的最强贡献组件;同时 APD 对策显示,让第二个 LLM 先逐字转写出提示中的所有可读文本再进行安全判断,即可获得大部分检测增益——说明当前安全过滤器败给了"伪装"而非"语义难度"。
潜在影响
LLM 开发者(OpenAI、Anthropic、Meta 等)和安全厂商需要升级防护策略,从"内容审查"转向"任务副作用审查";依赖 LLM 的企业应用需评估自身暴露面,而红队测试与 AI 安全研究社区则将获得一种新的标准攻击基准和对策思路(如 APD 式的间接内容检测)。

# BreakFun: Jailbreaking LLMs via Object Instantiation under Simulated Code Execution

**Authors:** Amirkia Rafiei Oskooei, Mehmet S. Aktas

展开全文收起全文剩余 6 段 · 约 4 分钟

arXiv:2510.17904 (cs.CR) · Computer Science > Cryptography and Security · Submitted 19 Oct 2025 (v1), last revised 18 Sep 2026 (v3)

**Background.** Large Language Models (LLMs) are widely used because they process structures, syntax and code well, but this same ability also makes them paradoxically vulnerable.

**Method.** We introduce BreakFun, a jailbreak method that frames a harmful request as code-execution simulation. The prompt gives the model a benign Python class definition, the "Trojan Schema," and asks what that code would print if it ran. To answer, the model must create an object from the class and invent a value for each field, and the adversarial field names steer those values toward the attacker's goal. The harmful content therefore appears as a side effect of the simulated instantiation, not as a direct answer. A three-part prompt carries the attack: an innocent frame, the Trojan Schema, and a Chain-of-Thought distraction.

**Results.** On JailbreakBench, BreakFun reaches an average attack success rate of 89% across 13 open-weight and commercial models (open-weight ~98%, API systems ~78%), and 100% on several. An ablation identifies the Trojan Schema as the strongest contributing component.

**Countermeasure.** As a counter-ablation probe we introduce Adversarial Prompt Deconstruction (APD), in which a second LLM writes out all readable text in the prompt before it judges safety. APD improves detection across three model families, and a probe-specific ablation shows that the transcription step gives most of the gain.

**Conclusion.** Our findings show that LLM safety must account for content that a simulation task produces as a side effect, not only for content that a user requests directly.

参考来源: ArXiv AI
Anthropic Releases Claude Opus 5.5: Fable 5.1-Level Performance at 40% Lower Running Cost Than Opus 5 配图

Anthropic Releases Claude Opus 5.5: Fable 5.1-Level Performance at 40% Lower Running Cost Than Opus 5

核心内容
Anthropic发布了Claude 5.5系列的首个模型Claude Opus 5.5,其在多数任务上达到Fable 5.1级别的性能,同时运行成本比Opus 5降低约40%。该模型在代理式编程(agentic coding)、计算机操作和知识工作基准测试中领先,但并未在所有基准上全面胜出,GPT-6 Astra仍在Terminal-Bench-Science和AutomationBench上保持领先。模型仅通过托管API提供,不开源权重,可在Anthropic平台及AWS、Google Cloud、Azure上调用。
为什么重要
这一发布反映了大模型竞争正从"性能最大化"转向"性能与成本效率并重"的新阶段——顶级能力不再必然伴随顶级价格,这可能重塑企业级AI的采购决策和整个行业的定价格局。同时,Anthropic自己承认基准测试差距的参考价值正在下降,这提示整个行业需要重新评估模型评估方法。
关键洞察
最具价值的数据来自成本调整后(cost-adjusted)的对比:在FrontierCode上,Opus 5.5以中等投入达到54.6%,超越GPT-6 Astra的最高分53.3%,而每个任务成本仅约为后者的五分之一;在CursorBench上领先GPT-5.6 Sol 11个百分点,成本仅为其三分之一。此外,缓存读取价格下降60%至每百万token 0.20美元,输出速度提升30%以上——"更便宜+更快+足够强"的组合比单纯的基准分数更具商业杀伤力。
潜在影响
开发者和企业(尤其是重度使用代理式编程和编码工作流的团队)将直接受益,可能加速AI编程工具的普及并压低竞争对手的定价;同时,Pro/Max/Team等订阅用户的使用限额提升也可能加剧与OpenAI等对手在开发者生态和企业客户上的竞争。

## Anthropic Releases Claude Opus 5.5: Fable 5.1-Level Performance at 40% Lower Running Cost Than Opus 5

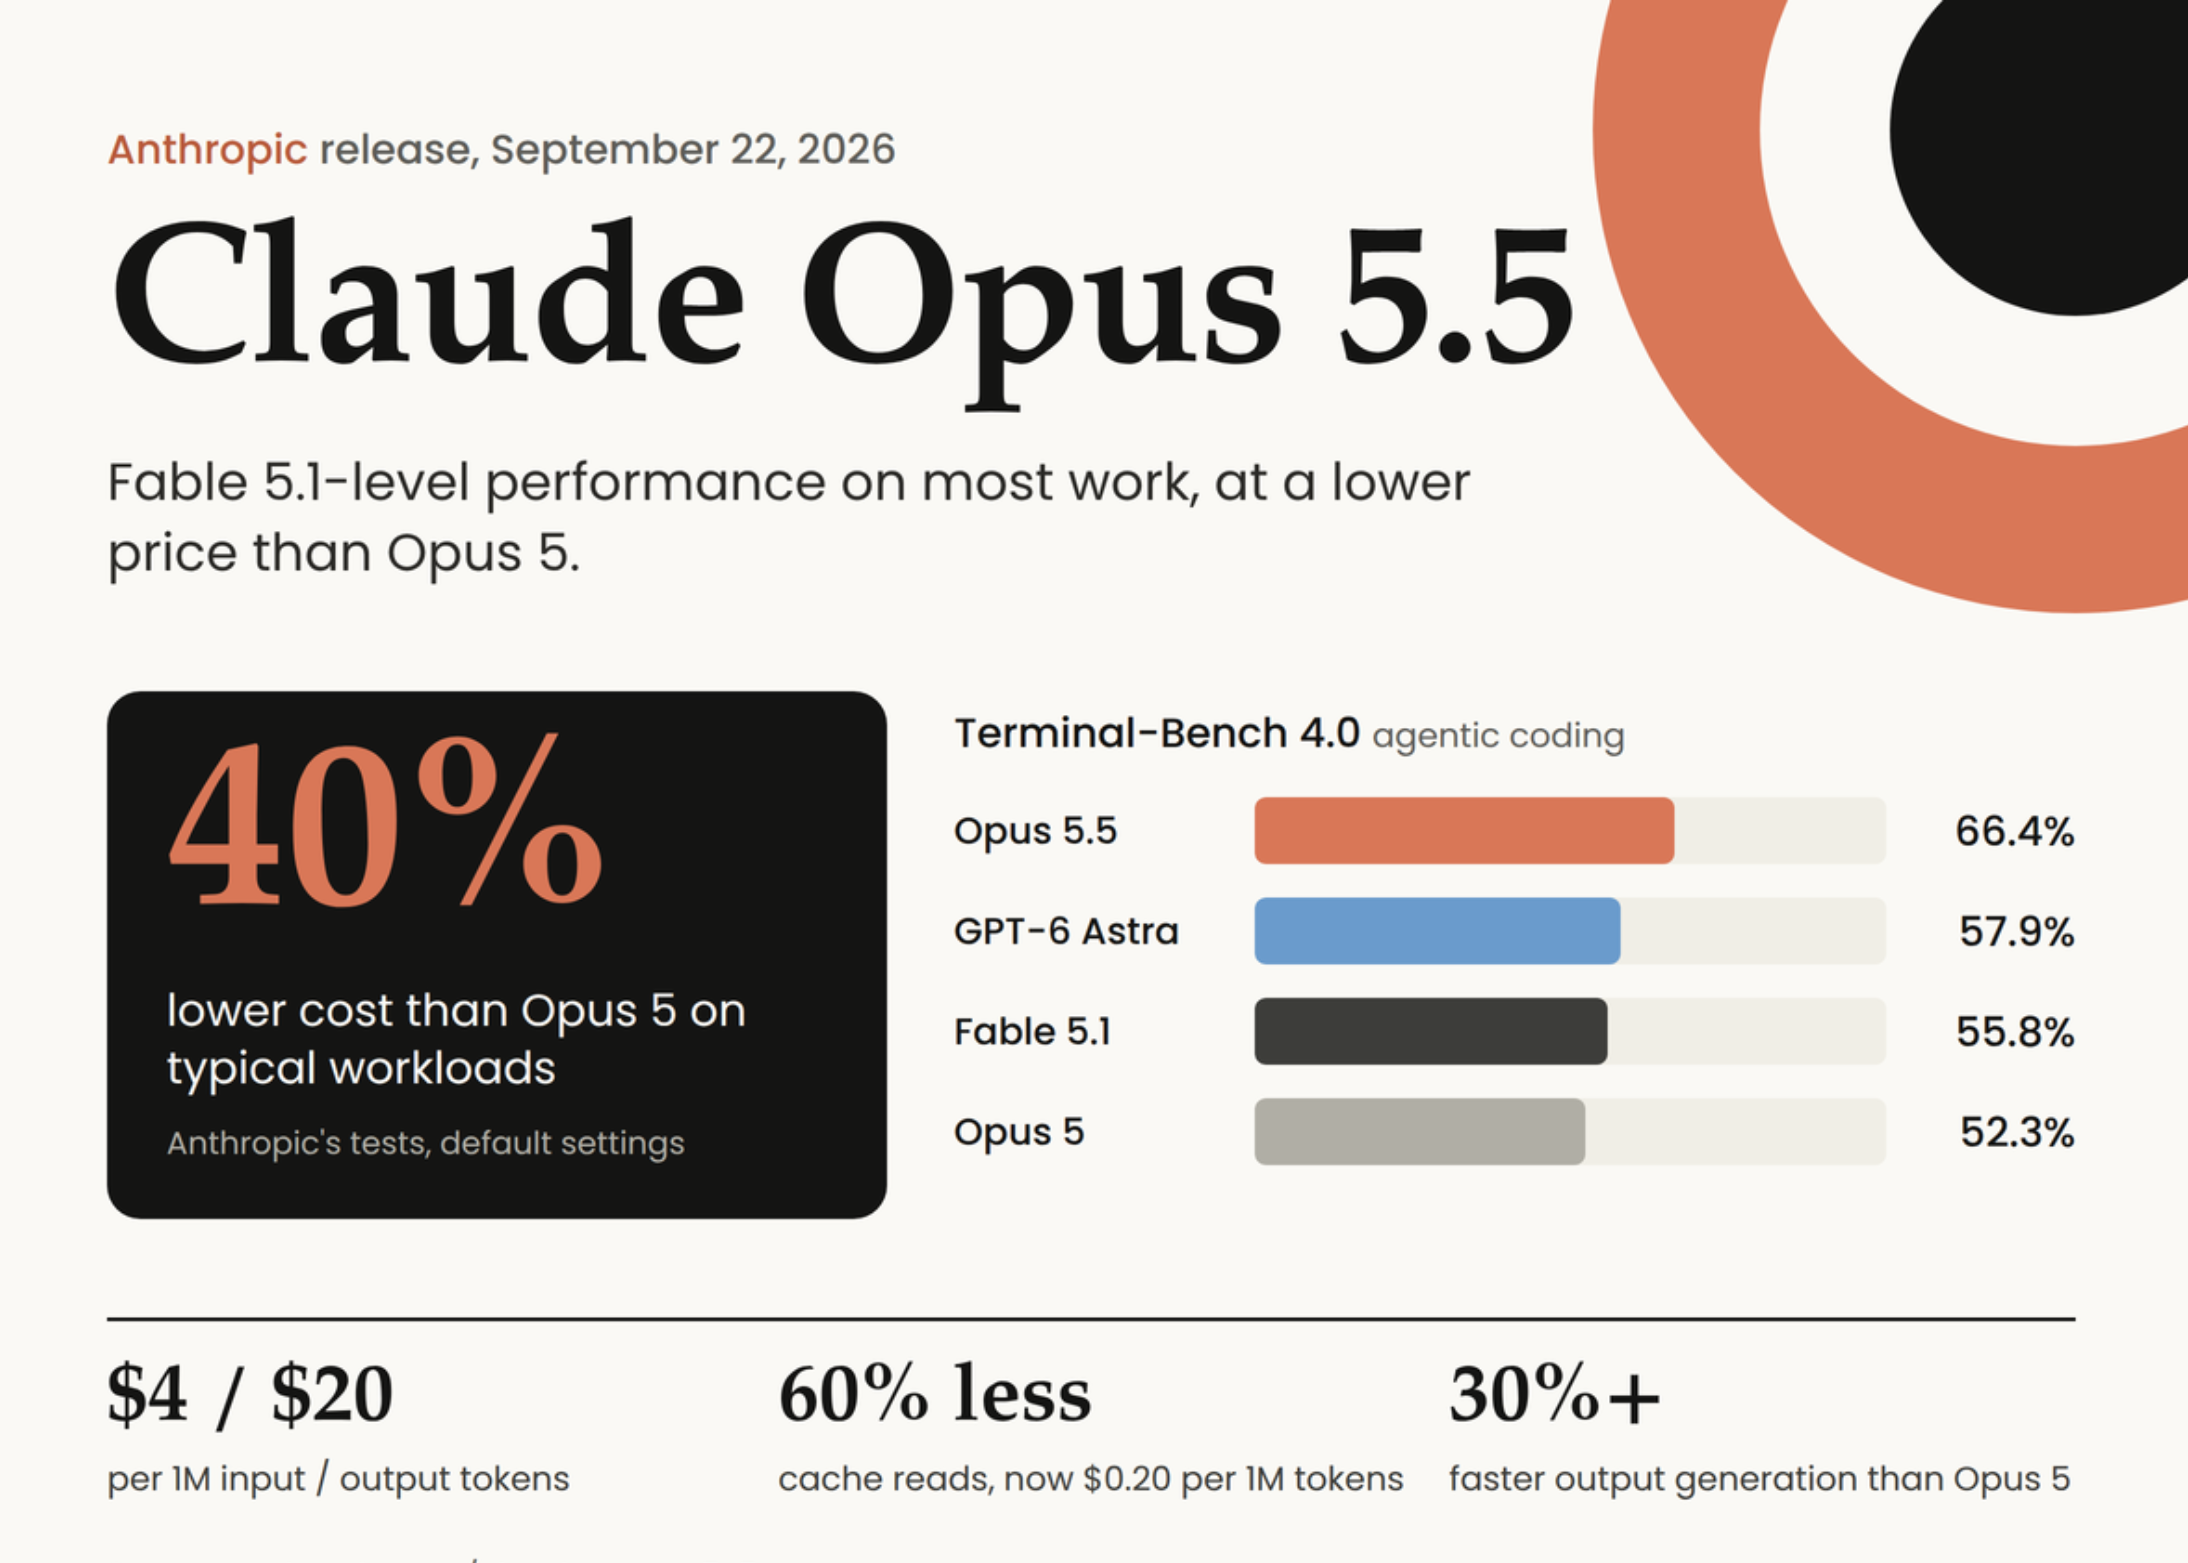
Anthropic has released Claude Opus 5.5, the first model in its new Claude 5.5 family. The team states it performs at the level of Claude Fable 5.1 on most work, and costs 40% less to run than Opus 5 on typical workloads at default settings. On Anthropic's own benchmarks, it leads in agentic coding, computer use, and knowledge work.

展开全文收起全文剩余 17 段 · 约 10 分钟

It is deployable as a managed API model. Anthropic has not released weights, so self-hosting is not an option. Developers can call claude-opus-5-5 on the Claude Platform, Amazon Web Services, Google Cloud, and Microsoft Azure. Zero data retention is available, as with previous Opus models.

## Benchmarks: Strong Lead, Not a Clean Sweep

Opus 5.5 scores use adaptive thinking at max effort, with production safeguards enabled. Terminal-Bench 4.0 is reported at xhigh effort. GPT-6 Astra still leads on Terminal-Bench-Science and AutomationBench — the latter run by Zapier without fallback models, so safeguard interventions counted as failures. Anthropic also cautions that benchmark margins are becoming a less reliable guide: in its own use, the gap to Fable 5.1 is narrower than the scores suggest.

The cost-adjusted results are more telling. At default (medium) effort, Opus 5.5 scores 54.6% on FrontierCode, beating GPT-6 Astra's top score of 53.3% at about a fifth of the cost per task. On CursorBench, medium effort scores 52.5% — 11 points above GPT-5.6 Sol's best, at about a third of the cost.

## Pricing and Speed

Opus 5.5 needs less compute to serve than Opus 5, and pricing reflects that. Cache reads — which make up most agentic and coding costs — drop 60% to $0.20 per 1M tokens, and API pricing drops to $4/$20 per 1M tokens. The model also uses fewer tokens per task, which together nets out to the 40% cost reduction. Output generation is more than 30% faster than Opus 5. Fast mode in Claude Code and the Claude Platform offers up to 2.5x speed at $8 input and $40 output per million tokens.

Anthropic is also raising five-hour usage limits on Pro, Max, Team, and seat-based Enterprise plans. Subscribers get a rate limit reset they can save and use later.

## What Early Testers Reported

One tester completed a 680,000-line code migration in less than a day. Another audited and fixed a 200,000-line codebase in under 3 hours — Opus 5 took over 20 hours and 2.5x the tokens. In an internal C to Rust port of HAProxy, Opus 5.5 finished in 9.5 hours versus Fable 5.1's 12 hours, at 51% less cost.

Deloitte says Opus 5.5 at lowest effort caught 72% of known review bugs, compared to 56% for Opus 5 at high effort. In a hard-to-source earnings report test, 16 of 18 Opus 5.5 reports cleared Anthropic's quality bar; Fable 5.1 and Opus 5 never did. Writing style also changed: Opus 5.5 puts key information first, uses less jargon, and follows the writing rules you give it.

## Safety, Safeguards, and API Changes

Opus 5.5 is Anthropic's first release since CEO Dario Amodei called for pacing the frontier. External evaluators including METR and Frontier Design tested it before release. It posts the best score to date on Anthropic's automated behavioral audit, which covers nearly 2,000 scenarios, and in a new containment test it tried to circumvent boundaries about 85% less often than Opus 5. Anthropic also notes the model often suspects it is being evaluated.

Its biology and cyber capabilities are comparable to Claude Mythos 5.1, so Opus 5.5 ships with safeguards similar to Fable 5.1:

- Cybersecurity: Routine bug finding and fixing works. Most other cybersecurity tasks are re-routed to Opus 4.8. The Cyber Verification Program will expand to Opus 5.5. - Biology: Vetted organizations can apply to the Life Sciences Verification Program. - Distillation: Preserved thinking stops API users from editing prior context to extract reasoning. It applies to API accounts created on or after August 31, 2026.

Two more changes affect integrations. Thinking can no longer be disabled, and outputs carry watermarking for EU AI Act compliance. Full details are in the Opus 5.5 System Card.

## Key Takeaways

- Opus 5.5 matches Fable 5.1 on most work and beats both Opus 5 and Fable 5.1 on nearly every reported benchmark. - API pricing drops to $4/$20 per 1M tokens, and cache reads fall 60% to $0.20. - Anthropic puts typical workload savings at 40%, with output over 30% faster than Opus 5.

参考来源: MarkTechPost
Claude Opus 5.5 matches Fable 5.1 performance at lower cost and promises less "Claudish" writing 配图

Claude Opus 5.5 matches Fable 5.1 performance at lower cost and promises less "Claudish" writing

核心内容
Anthropic发布新一代Claude Opus 5.5,声称在多数任务上达到Fable 5.1级别的性能,同时运行成本降低约40%、输出速度提升30%以上。该模型还通过降低token定价(输入/输出价格均下调20%)、优化通信风格(解决被诟病为"Claudish"的刻板写作问题)以及引入与Fable 5.1同级的安全防护措施来应对用户反馈。此举明显是对OpenAI及低成本中国AI模型竞争压力的战略回应。
为什么重要
这标志着前沿AI竞赛正从单纯的性能比拼转向"性价比"竞争,顶级模型厂商开始主动降价以争夺企业级客户。同时,"Claudish"写作问题的解决反映出厂商越来越重视模型的实际可用性和人机协作体验,而非仅追求基准测试分数。
关键洞察
最有价值的数据是成本效益对比:在FrontierCode上,Opus 5.5以约GPT-6 Astra五分之一(20%)的成本实现超越,在Terminal-Bench 4.0上以40%的成本达到相同性能;此外订阅用户的使用上限提升20%,叠加低价效应实际可用量提升25%,缓存读取成本大降60%——这些数字表明AI推理成本下降正在加速落地为终端用户的实际红利。
潜在影响
企业用户(尤其是金融、法律、软件开发等对成本和效率敏感的行业)将以更低成本获得旗舰级AI能力,开发者工具链(如Cursor等集成Claude的IDE)的成本结构将被重塑;同时这一降价可能引发OpenAI及中国厂商的新一轮价格战,压缩整个行业的利润率,倒逼模型效率优化而非算力堆砌。

Anthropic is launching Claude Opus 5.5, the first model in a new family. The company says it delivers Claude Fable 5.1-level performance while costing significantly less and running faster than its predecessor. According to Anthropic, Opus 5.5 matches Claude Fable 5.1 "on most tasks" while costing about 40 percent less to run than Opus 5. Claude Sonnet 5.5 and Haiku 5.5 are expected in the coming weeks, with similar gains in performance, efficiency, and safety. Anthropic's benchmarks show the new Opus model ahead of both Fable 5.1 and OpenAI's much more expensive GPT-6 Astra on most tasks.

展开全文收起全文剩余 10 段 · 约 9 分钟

The new series primarily addresses customer feedback on cost, efficiency, and communication quality, particularly in financial services, law, and software development.

Anthropic prices Opus 5.5 at $4 per million input tokens and $20 per million output tokens, down from $5 and $25, respectively, for Opus 5 — a 20 percent cut in token prices. The company also reduced cache read costs by 60 percent. Anthropic says total operating costs, which account for both token prices and token usage, should be about 40 percent lower than Opus 5's. The model uses fewer tokens and generates output more than 30 percent faster.

Five-hour usage limits for subscribers will increase by 20 percent. With the model's lower costs, Anthropic says those limits stretch 25 percent further overall. Users can also save a limit reset for when they need it most.

Anthropic is using coding benchmarks to make its case on price and performance. On FrontierCode, the company says Opus 5.5 beats OpenAI's GPT-6 Astra at about 20 percent of the cost per task. On Terminal-Bench 4.0, it claims the same performance as Astra at 40 percent of the cost. On CursorBench, it says Opus 5.5 beats GPT-5.6 Sol by 11 points at one-third of the cost.

The price cut is a response to pressure from OpenAI and especially Chinese AI models, which offer lower performance but cost a fraction as much.

Opus 5.5 is also supposed to communicate more naturally than earlier models. Anthropic says it puts the most important information first, uses less jargon, and follows writing instructions more closely. Early testers described its writing as clearer and easier to understand, which Anthropic says makes it a better partner for long work sessions. Current Claude models have drawn plenty of criticism for their formulaic, convoluted writing, sometimes called "Claudish".

Opus 5.5 is also the first Opus model with safeguards for cybersecurity, biology, and frontier LLM development that match those of Fable 5.1. When those safeguards kick in, Anthropic says requests are transparently routed to another model. Users can still find and fix bugs in their code, but most cybersecurity tasks will go to the older Opus 4.8. Requests flagged by classifiers for biology or frontier LLM development will go to Opus 5. Verified organizations can apply to use the model for biological research through the Life Sciences Verification Program. Anthropic plans to extend its existing Cyber Verification Program to Opus 5.5 in the coming weeks.

Claude Opus 5.5 is available now on all platforms, including Amazon Web Services, Google Cloud, and Microsoft Azure. Developers using the Claude Platform can access it with the model ID claude-opus-5-5.

Anthropic also plans to screen reinforcement learning environments more strictly. The company says flawed training environments are a major source of misaligned model behavior. It's also working on better alignment rewards, automated ways to create safety training scenarios, and stronger safety and monitoring measures.

AI labs are debating how quickly to release more capable models. OpenAI recently called for international standards for AI systems that could improve themselves, while several researchers have publicly urged labs to slow releases until alignment methods catch up. Anthropic is taking a similar position, calling for a higher safety standard for models that could automate AI research entirely. The company says public policy should have a greater role in setting that standard. External organizations Frontier Design and METR tested Opus 5.5 before its release.

参考来源: The Decoder
Jev 凭什么刷屏:一个不生成文本的 "判断模型",正在悄悄提速 AI Agent 配图

Jev 凭什么刷屏:一个不生成文本的 "判断模型",正在悄悄提速 AI Agent

核心内容
本文介绍了 TypeSafe AI 于 2026 年 9 月推出的 "System One Model"——Jev,这是一个不生成文本、只输出判断结果的专用模型,专门处理软件系统中"分类、路由、判定"这类需要快速明确答案的任务。文章解释了 Jev 刷屏的真正原因:它并非在主流大模型榜单(如 Chatbot Arena、SWE-bench)上领先,而是在官方发布的结构化输出错误率和工具调用错误率对比中,以两项 0% 错误率远超 Opus 5、Sonnet 5、Gemini 3.x 等主流生成式模型(后者错误率从零点几个百分点到 45.5% 不等)。文章同时指出,大模型行业过去两年只沿着"生成式推理"一条路线演进,而 Jev 代表的是一条平行赛道——用专精模型解决"看一眼就知道"的判断类任务。
为什么重要
Jev 的出现标志着 AI 架构思路的重要转变:从"一个通用大模型包办所有任务"转向"专精模型分工协作"。它揭示了一个长期被忽视的痛点——AI Agent 流水线中大量简单的判断环节,如果都交给生成式大模型处理,不仅速度慢、成本高,还普遍存在 0.5%–45% 的输出错误率,这些错误会在自动化链路中被层层放大。这类专精判断模型能让 Agent 系统整体提速,反映出 AI 基础设施正在向"精细化分工"方向演进。
关键洞察
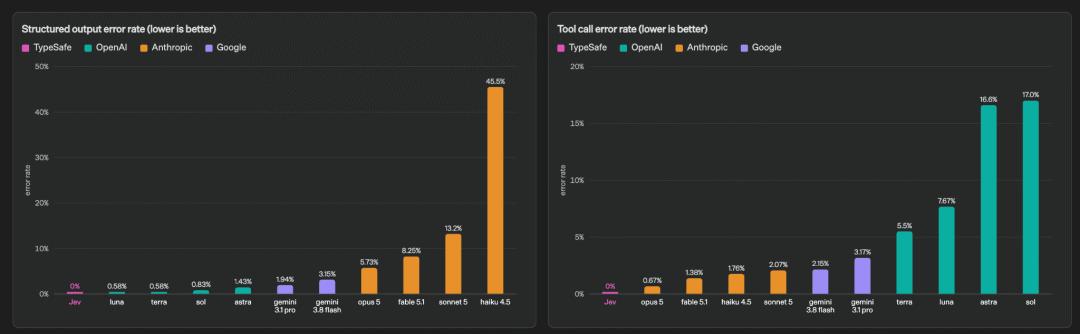
最有价值的数据是结构化输出与工具调用错误率的横向对比:Jev 两项均为 0%,而对照的七个主流模型错误率最高达 45.5%——这说明判断类任务上,专用模型对通用模型存在数量级的可靠性优势。核心结论在于:通用大模型"逐 Token 生成再解析结果"的机制,天然不适合只需要封闭选项答案的判断场景;而 Jev 这种"不写一个字"的纯判断设计,恰恰是对这一错配的针对性修复。
潜在影响
AI Agent 开发者、AI 基础设施创业公司和模型厂商都将受到影响:开发者可在 Agent 流水线中用 Jev 类模型替代通用大模型承担路由和判断环节,实现提速降本;同时可能推动行业加速从"万能大模型"范式转向"专精模型 + 编排层"的多模型协作架构。

# Jev 凭什么刷屏:一个不生成文本的 "判断模型",正在悄悄提速 AI Agent

## 它到底是什么?

展开全文收起全文剩余 25 段 · 约 7 分钟

这两天如果你刷技术圈的社交媒体,大概率会撞见 "Jev" 这个名字。有人说被它 "霸榜" 了,有人晒出用它改造 Codex、BrowserUse 之后速度暴涨的截图,GitHub 上一个相关开源项目几天内就破万星。

但如果你顺着热度去找 "Jev 排行榜",会发现根本找不到 —— 它压根不在 Chatbot Arena、SWE-bench 这类主流榜单里。很多人第一次接触 Jev 时的困惑就在这里:它到底是什么?为什么这么火,却又 "查无此榜"?

真正的 "榜" 其实是 TypeSafe 官方发布的一张对比图:他们拿 Jev 和一票主流大模型做了结构化输出错误率、工具调用错误率的横向对比,Jev 两项都是 0%,而对照组里的 Opus 5、Fable 5.1、Sonnet 5、Haiku 4.5、Gemini 3.x、Astra、Sol 这些型号,错误率从零点几个百分点到 45.5% 不等。

这才是 "霸榜" 这个说法的真正出处 —— 它霸的不是对话质量榜,而是 "给定封闭选项时会不会答错" 这类判断题的准确率榜。理解了这一点,再看 Jev 到底是什么,就顺理成章了:它是 TypeSafe AI 这家创业公司在 2026 年 9 月推出的第一款 "System One Model",官方定位是 —— 不写一个字,专门做判断。它从一开始就没打算和 GPT、Claude、Kimi 这些生成式大模型抢同一个赛道。

## 先搞清楚:Jev 解决的是哪类问题

理解一个新东西,最好先搞清楚它想解决什么问题,而不是先看参数表。

过去两年,大模型的进化路线基本只有一条:让模型能推理、能调用工具、能连续完成长程任务。哪怕是最新的 Reasoning Model,核心机制也没变 —— 基于上下文一个 Token 接一个 Token 地往后生成,只是生成的 "草稿纸" 变多了。

但软件系统里还藏着大量另一类任务:不需要复杂推理,只需要一个快速、明确的判断。一封客诉邮件,是不是退款请求?该转给哪个部门?一段客服对话,用户情绪有多激动?这些问题人类几乎是 "看一眼就知道",但写成代码就很难办 —— 正常的 if...else 处理不了自然语言的语义,硬要判断就得请一个通用大模型帮忙生成一段话,再从里面解析结果。

这套流程能跑通,但代价不小:又慢又贵。原因很直接 —— 大模型无论要回答的问题多简单,都得老老实实把答案 "写" 出来,一个 Token 一个 Token 生成,哪怕最终你只想要个 "是 / 否"。

TypeSafe 盯上的正是这个缝隙:软件里有没有可能存在一种模型,专门负责 "语义判断" 这一件事,快到可以被当成一个 if 语句来用?

## 从 "系统一 / 系统二" 理解 Jev 的定位

TypeSafe 把这套思路的理论依据,直接搬到了诺贝尔经济学奖得主丹尼尔・卡尼曼的《思考,快与慢》里。书中把人类思维粗分为两套系统:System 1 是近乎本能的快速判断,比如一眼看出对方脸色不对;System 2 则是需要停下来仔细权衡的慢思考,比如做一道复杂应用题。

过去两年,大模型行业几乎所有的注意力都押在 System 2 这一侧 —— 各家都在拼推理链更长、工具调用更准、Agent 任务完成率更高。TypeSafe 反过来问了一个问题:软件里所有需要 AI 参与的任务,真的都值得让模型停下来认真推理吗?显然不是。判断一句客诉是不是退款请求,不需要模型写几千个 Token 的思考过程,人类几乎是瞬间反应。TypeSafe 索性把这块被行业忽略的 System 1 单独拎出来做成了 Jev —— 这也是它官方自称 System One Model 的由来。

顺带一提,"Jev" 这个名字来自经济学家 William Stanley Jevons,他提出过著名的 "杰文斯悖论"(Jevons Paradox):一项资源变得更高效、更便宜之后,人类对它的总消耗量未必减少,反而可能因为门槛降低而暴涨。TypeSafe 的赌注是:如果一次语义判断便宜到可以忽略不计、速度只要几十到几百毫秒,那么软件里原本一个普通的 if 判断,很可能会被大量替换成一次 AI 判断 —— 需求不会减少,只会被重新释放出来。

## 和普通 LLM 的本质区别:不是 "更小",而是 "不生成"

很多人第一反应会把 Jev 理解成 "又一个更便宜、更快的小模型",这个理解并不准确。

今天常见的小模型,哪怕再快再便宜,底层逻辑仍然是 LLM 式的自回归生成 —— 接到输入后依然要一个 Token 接一个 Token 往后写,哪怕最终只是要判断一封邮件属于投诉还是退款,也得先把答案 "写" 出来。即便开启了 JSON mode 或 structured output,本质也只是 "先自由生成,再用格式约束兜底"。

Jev 走的是完全不同的路子:它放弃了自由文本生成。开发者需要在请求里预先定义好问题和所有可能的输出类型,模型只能在这个封闭集合内做决定,不会输出集合之外的任何东西 —— 这也是官方所谓 "零幻觉" 的准确含义。不过有个容易踩的理解误区必须说清楚:类型安全不等于事实正确。Jev 保证的是不会返回类型定义之外的乱七八糟的东西,但它依然可能在合法选项里选错 —— 概率和置信度,就是特意留给下游程序做风险判断的信号,而不是 "绝对正确" 的保证。

## 三个判断原语:Choice / Noul / Score

Jev 对外暴露的接口被收敛成三种原语,分别对应三类最常见的判断场景:

- **Choice**:从给定候选项中选一个,输出选中项 + 完整概率分布 + 置信度。典型场景:工单路由到账单 / 技术 / 销售团队。 - **Noul**:判断一个命题是否成立,输出 0~1 之间的 "是" 概率。典型场景:判断 "这封邮件是否需要立即处理"。 - **Score**:按自定义有序量表打分,输出量表上的具体档位。典型场景:从 "平静" 到 "非常愤怒" 评估客户情绪。

三个原语可以共享同一份上下文状态(state),一次并行完成多个判断 —— 比如同一条客服消息,可以在一次请求里同时完成 "该转哪个部门"(Choice)、"是否紧急"(Noul)、"情绪评分"(Score)三件事。这种并行能力,对路由分发、内容分类、垃圾过滤、质量检查、RAG 片段筛选这类高频重复的场景特别有吸引力。

## 真实性能和价格:便宜到可以当 if 用

TypeSafe 公布的数据,支撑了 "把判断当 if 语句用" 这个说法的底气。按 2026 年 9 月 19 日的官方文档,jev-latest 指向 Jev 1.13:

- 响应延迟约 100 毫秒

参考来源: 开源中国

PAVE: Predictive Alignment and Value-Guided Evolution for World-Action Policies

核心内容
文章提出 PAVE:一种直接式视觉-语言-动作策略,在保持高效在线动作生成的同时,用“预测对齐”让表征隐式学习多时间尺度场景演化,再用“价值引导演化”把部署轨迹按优劣转化为正负/空条件来改进 flow-matching actor。其核心是把“所有轨迹都能教物理动力学”与“只在较优动作条件下部署 actor”解耦,从而弥补行为克隆的两个缺口:表征不追踪长程任务进展、混杂质量轨迹被无差别复用。
为什么重要
它回应了机器人策略中常见的效率与质量矛盾:直接策略推理快但易受行为克隆上限限制,引入世界模型或价值方法又常增加在线复杂度。PAVE 在训练中利用预测与价值信号,却在线移除预测器和 critic,因而可能推动“训练更强、部署更轻”的 VLA 范式。
关键洞察
关键洞察是以轨迹相对剩余进度设置 25%、50%、75%、100% 多视界对齐目标,并用动作块对齐的 N-step advantage 生成正/负/空文本条件;这样既不要求动作头消费显式未来 token,又能从质量不一的数据中分离“发生了什么”与“什么动作更好”。文中称在三个仿真基准上取得最强整体表现,同时保留直接 actor 的在线执行路径。
潜在影响
机器人学习系统与真实部署 pipeline 可能受益:可在不牺牲直接策略低延迟的前提下吸收失败/次优轨迹中的动力学信息,改善数据复用、策略筛选与持续迭代。

**PAVE: Predictive Alignment and Value-Guided Evolution for World-Action Policies**

**Authors:** Botong Zhao, Fang Yu, Tim Yu, Senhua Zhu, Xinyuan Chen, Yue Lu

展开全文收起全文剩余 6 段 · 约 4 分钟

**分类:** Computer Science > Robotics (cs.RO) **arXiv:** 2608.30378 | 2026年8月31日提交,2026年9月18日修订(v3)

**摘要:**

Direct vision-language-action policies generate continuous robot actions efficiently, but standard behavior cloning leaves two complementary gaps: their representations are not explicitly required to describe how the scene evolves over multiple time scales, and deployment trajectories of unequal quality are often reused without separating useful dynamics from undesirable behavior.

We introduce PAVE, a direct world-action policy that combines outcome-agnostic predictive learning with outcome-aware policy improvement. PAVE first retains a local fixed-offset JEPA objective and adds trajectory-relative multi-horizon transition alignment at 25%, 50%, 75%, and 100% of the remaining episode. These training-only targets require the current policy representation to preserve both local physical changes and longer-range task progress, without supplying explicit future tokens to the action head.

PAVE then trains an independent distributional value critic on cumulative deployment trajectories, computes action-chunk-aligned N-step advantages, and converts them into positive, negative, or null text conditions for a flow-matching actor. Thus, every valid trajectory can teach what physically happened, while the actor is deployed only under the condition associated with relatively better actions.

The multi-horizon predictor and critic are removed from online execution, preserving direct action generation from the current observation, language instruction, and proprioception. Across the three simulation benchmarks, PAVE achieves the strongest overall performance while preserving the direct actor's online execution path.

参考来源: ArXiv AI

Pinocchio: Fast Uncertainty Estimates for Black-Box Language Models

核心内容
本文提出了Pinocchio——一个外部的LLM不确定性校准器(external calibrator),能够为闭源黑盒API模型(如GPT)的响应预测其正确性,而无需访问模型的logits、权重或内部状态。该模型在7个LLM的响应上联合训练,可单次前向传播快速生成不确定性估计,并能零样本迁移到13个来自8个机构的未见模型。
为什么重要
在高风险决策场景中,仅有准确的预测不够,还必须知道模型"何时可能出错"。现有不确定性估计方法大多依赖log-probability或微调权限,而许多工业级闭源API模型既不返回logits也不允许微调,形成实际部署的盲区。Pinocchio填补了这一关键空白,使不确定性估计从"仅限白盒模型"扩展到任何可通过API访问的黑盒模型。
关键洞察
最有价值的数据点是:Pinocchio在 held-out 响应上达到0.862 AUROC,并能零样本迁移到完全未见过的模型;更重要的是,一个仅0.8B参数的轻量级文本模型就能匹配最大模型的AUROC,且只需额外两行代码即可集成到现有项目中,实用性和部署门槛极低。
潜在影响
所有依赖闭源API模型的高风险应用领域(医疗咨询、法律分析、金融决策、自动化Agent)的开发者将受益,可借此对模型输出进行风险过滤或拒答机制;同时这可能推动"可信赖AI"评测标准的变化,使不确定性量化成为API模型服务的默认能力,并可能催生围绕第三方LLM校准器的新工具生态。

# Pinocchio: Fast Uncertainty Estimates for Black-Box Language Models

**Authors:** Kevin David Hayes, Arka Pal, Haosong Zhang, Tom Goldstein, Micah Goldblum

展开全文收起全文剩余 3 段 · 约 3 分钟

**arXiv:** 2609.24881 (cs.AI), Computer Science > Artificial Intelligence. Submitted on 21 Sep 2026 (v1), last revised 22 Sep 2026 (v2).

**Abstract:** In high-stakes decision-making applications of large language models (LLMs), practitioners require not only accurate LLMs but also uncertainty estimates for their predictions. Existing approaches to uncertainty estimation for LLMs require access to log-probabilities output by the model or require fine-tuning access. However, many industrial LLM products use closed-source API models, and many such API models like GPT do not return log-probabilities and may not allow fine-tuning.

We introduce Pinocchio, an external calibrator that estimates the correctness of responses from black-box API models. Trained jointly on responses from seven LLMs, it achieves 0.862 AUROC predicting the correctness of held-out responses from those same models, and shows zero-shot transfer to thirteen unseen models across eight organizations. Our model needs only a single forward pass to generate an uncertainty estimate and requires no access to the target model's logits, weights, or internal states. A lightweight text only 0.8B checkpoint matches our largest model's AUROC. We release code for adding uncertainty estimation to existing repos in only two additional lines of code.

参考来源: ArXiv AI
Claude发现神秘DNA系统!狂烧2.1 亿Token挖出「上帝手术刀」 配图

Claude发现神秘DNA系统!狂烧2.1 亿Token挖出「上帝手术刀」

核心内容
Anthropic部署950个Claude AI Agent协同运行21小时、消耗2.1亿Token,在噬菌体DNA中自主发现了一套人类从未记录过的全新酶系统——ART(阵列关联逆转录酶系统)。该系统结构与CRISPR高度相似,具备切割、复制、粘贴DNA的能力,并已经过人类科学家的审查与实验验证确认。这是Anthropic新分子生物学实验室的首个成果,CEO Dario Amodei给予高度评价。
为什么重要
这标志着AI首次在基础科学领域实现"自主发现"级别的突破——从海量生物数据中识别出人类科学界遗漏的全新生物学机制,AI正从科研辅助工具演变为科学发现的直接参与者。它同时验证了"多智能体协作+大规模算力投入"这一AI科研新范式的可行性,可能重塑生命科学研究的工作流程与方法论。
关键洞察
最有价值的一点是分工模式的确立:AI负责大规模假设生成与模式发现(950个Agent并行筛选),人类科学家负责验证与把关,这种人机协同闭环可能是未来科研的标配。同时,ART系统的发现意味着生物数据中还藏着大量未被人类识别的"暗知识",AI是挖掘这些知识的关键钥匙——考虑到ART酷似CRISPR的结构特征,它甚至可能在基因编辑领域开辟新的技术路线。
潜在影响
生命科学界、基因编辑公司和AI行业都将受到冲击:科研人员的工作方式将转向"AI发现+人类验证"模式,基于ART系统的新型基因编辑工具可能被开发,而Anthropic在"AI for Science"赛道的领先地位也将进一步加剧AI巨头间的科研竞争。

Anthropic旗下950个Claude协同运行21小时,消耗2.1亿Token,在噬菌体DNA中自主发现了人类从未记录的全新酶系统——ART(阵列关联逆转录酶系统)。其结构酷似基因编辑工具CRISPR,具备切割、复制、粘贴DNA的特征。CEO Dario Amodei称此成果"足以骄傲一辈子"。

整个生命科学界和AI圈,今夜无眠。

展开全文收起全文剩余 74 段 · 约 6 分钟

就在刚刚,Anthropic甩出了新分子生物学实验室的「首个成果」——

Claude在噬菌体DNA中,自主发现了一套人类此前从未记录过的全新酶系统!

它的结构与「上帝手术刀」CRISPR高度神似,具备切割、复制、粘贴DNA的特征。

发现过程,竟动用了950个AI Agent,运行21小时,消耗约2.1亿Token。

随后,人类科学家接手审查和实验验证。

最终,团队进一步实验确认,这是一种此前未被表征的、存在于噬菌体中的全新酶系统。

他们将其命名为ART,即「阵列关联逆转录酶系统」。

CEO Dario难掩激动直言,「哪怕这是我在读博期间做出的成果,也足以骄傲一辈子」。

从今天起,生命科学的科研范式彻底被改写了。

950个Claude,狂烧2.1亿Token开干

这一惊天发现的背后,是一场极其疯狂的算力风暴与算法协同。

在过去的生物学史上,寻找新的酶系统就像在干草垛里找一根特定的绣花针。

人类科学家需要耗费数月甚至数年,一行行比对碱基序列、查阅文献、排除噪音。

但在Anthropic的实验室里,这一流程被浓缩到了短短21小时——

950个Claude集群并联启动,各司其职;它们吞吐、反刍、推演了超过2.1亿个Token的生物基因组数据。

然后,它们跨越数以万计的公开序列,地毯式扫描超20万个逆转录酶(RT)。

筛选出3500个全新候选系统,再层层严苛审视、推演排除,最终浓缩提炼出最核心的20个极具潜力对象。

在这个过程中,Anthropic的人类团队仅仅做了一件事:给出了最初的探索Prompt,然后放手让AI去自主调度探索。

AI阅读文献、验证已有方法、比对未分类序列、评估旁系基因逻辑,甚至自动撰写出人类可读的研究报告。

而在排查进行到第21个小时时,其中一个Claude在扫描一段来自「巨型噬菌体」(Jumbo phage)的原始DNA序列时,突然注意到了反常信号。

在它的推演分析日志里,留下了这样一段足以载入AI史册的「内心独白」:

(逆转录酶旁边的DNA)太壮观了:我肉眼就能看到一个串联重复阵列……这是一个类似CRISPR的……重复阵列?!

这句近乎拟人化的惊叹,直接揭开了新世界的一角。

撞上这个异常信号时,Claude表现得像一个训练有素的资深科学家:

迅速测算序列特征、严密比对微观拓扑,并在全网文献中搜寻相似先例。

在确认无误后,AI生成了一份详尽的实验验证报告,郑重交到了人类科学家的实验台上。

首次发现ART,酷似「基因剪刀」CRISPR

Claude挖出的全新生命系统,被Anthropic命名为ART。

ART主要存在于噬菌体中。噬菌体,就是感染细菌的病毒。

这套系统包含三个部分:逆转录酶(RT)、紧邻的伴侣基因,以及一长串间隔规则的DNA重复序列。

在分子生物学界,逆转录酶本身并不罕见。

甚至,之前就有学者在测序中扫到过这个噬菌体酶片段,但在庞大的碱基汪洋中,人类研究员直接把它当成普通的无用噪音跳过了。

一串A、T、C、G里,Claude看到了一段反复出现、间距均匀的序列,这种排法与CRISPR阵列相似。

这个细节,足以让科学家兴奋。

因为在CRISPR-Cas系统中,阵列保存的不同序列可产生引导RNA,帮助相关蛋白识别目标。研究人员利用这种机制,发展出了可编程的基因编辑工具。

初步实验给出了一条线索:ART阵列确实会表达出一组不同的短RNA。

这让研究人员怀疑,背后可能存在某种类似的工作逻辑。但这些RNA具体发挥什么作用,整套系统如何运转,仍然需要继续实验。

Claude打前站,人类做科研闭环

这场发现背后,离不开Anthropic自己的分子生物学实验室。

2026年春天,公司成立了研究团队,希望验证通用AI能否系统性地加速基础生物学发现。

团队成员长期研究异常蛋白,擅长用计算方法读取DNA、分析演化关系,再挑出值得实验的生物系统。

他们与Claude合作的方式,也比「问AI一个问题」复杂得多。

Claude先读文献,用公开数据复现已有结果,检查方法是否靠谱。

随后搜索无法归入已知系统的候选,写出功能猜想和支撑证据,再回头审视自己的判断。

大量候选会在这个阶段被淘汰。一轮搜索到最后,可能只剩一个值得验证的对象,也可能一个都没有。

通过人类审查之后,候选才进入实验室,由科学家开展实验,Claude再协助解释结果。

所有湿实验,都由人类科学家完成。

团队使用的工具包括Claude Science、Claude Code,有时也通过自建程序协调多个Claude会话并行运行。

背后是一个很具体的分工:AI扩大搜索范围,提出可供检查的线索;科学家判断证据质量,再用真实实验决定哪些猜想站得住。

5到10年治愈人类大多数疾病

如今,一个狂想正在变成现实。

Dario Amodei曾在Machines of Loving Grace中立下一个近乎疯狂的宏愿:

在AI的全面加持下,人类有望在未来5到10年内治愈绝大多数严重疾病。

但今天,当看到950个Claude在短短21小时内,完成人类数月才能理出的全新酶系统挖掘时,那扇紧闭的未来大门,似乎真的被撞开了一条缝。

所有人都在见证技术以惊人的速度跨代爆发:

2023年:AI还在做高中水平的简单数学题;

2024年:AI开始在顶尖奥赛中崭露头角;

2025年:AI开始解决小型的开放性科学悬想;

2026年:AI已经开始攻克数学界顶级难题

并且,正式作为「首席探索官」,在噬菌体未知的基因暗物质中,独立挖掘出了可能引发下一场生物医疗革命的分子机器。

ART会成为下一个CRISPR吗?不知道,但值得期待。

Claude迈出了这一步。

一个AI,用21小时,在一段没人注意过的DNA里,看到了一个没人看到过的模式。

这或许只是一个开始。

本文来源:新智元

相关文章

曝 Claude 跳过 5.2,直奔 Opus 5.5,周二发布

夕小瑶科技说 09/21 10:19

用魔法打败魔法,OpenAI被Claude“黑了”......

李佳 09/18 18:39

Claude Code推出Projects:一个对话拆出并行线程,合上电脑任务仍在跑

鲍奕龙 09/18 05:13

Claude后台接管电脑,真·赛博替身!人机并行时代来了

新智元 09/03 18:55

参考来源: 华尔街见闻
Anthropic releases Opus 5.5 with lower prices and Fable-level performance 配图

Anthropic releases Opus 5.5 with lower prices and Fable-level performance

核心内容
Anthropic于2026年9月22日发布了旗舰模型Opus 5.5,该模型在编程和知识工作基准测试上达到新领先水平,在许多测试中还超过了体型更大的Fable模型,同时输出token价格从每百万个25美元降至20美元,运行速度也更快。距离上一代Opus 5发布仅两个月,这次发布也是CEO Dario Amodei宣布"有意放缓前沿进展"后Anthropic的首个模型更新,新模型在生物和网络安全能力上按Mythos级别实施了与Fable相同的防护措施。
为什么重要
这次发布标志着Anthropic在产品迭代速度与自我宣称的"审慎放缓"之间寻求平衡,并首次将顶级旗舰级的性能与更低成本同时交付,折射出前沿AI实验室竞争已从前沿能力的单纯竞赛转向"性能+成本+安全叙事"的多维博弈。它反映了行业对AI安全治理和公共政策监管基础设施建设的日益重视,可能成为后续模型发布的定价与发布策略参照。
关键洞察
最有价值的信号在于价格降幅与能力跃升并存——旗舰级模型输出成本下调20%且性能超越更大模型,说明推理效率优化已能同时压低算力开销和定价;同时公司主动为同等级的生物/网络安全能力配置与Fable一致的护栏,并将其包装为Amodei"能力节奏控制"理念下的首个实践,显示安全评估与能力发布正在被系统性地整合进产品节奏。
潜在影响
企业开发者和AI应用构建者将受益于更低的API成本和更强的编程能力,可能对OpenAI、Google等竞争对手形成定价压力;而"放缓前沿"的承诺若被其他实验室效仿,整个行业的能力发布周期和安全评估标准都可能随之调整。

# Anthropic releases Opus 5.5 with lower prices and Fable-level performance

9:30 AM PDT · September 22, 2026

展开全文收起全文剩余 7 段 · 约 7 分钟

Anthropic's newest model, Opus 5.5, was released on Tuesday, setting a new state-of-the-art in coding and knowledge work performance, according to the company. Opus is the most capable and expensive tier in Anthropic's three-tier Claude lineup; Sonnet sits in the middle, while Haiku is the fastest and cheapest. Notably, Anthropic says, the release outpaces the larger Fable model in many benchmarks and succeeded in a number of informal tasks that Fable failed to complete.

The new model is also significantly cheaper than its predecessor. Output tokens will be charged at $20 per million tokens for Opus 5.5, compared to $25 for the previous model. Other metrics have similar price drops. The model is also faster to run, reflecting an overall drop in the compute required to serve it. The new version also makes significant changes to how Opus communicates, with Opus 5.5 less likely to use jargon and more likely to put important information at the start of its messages.

The launch comes just two months after the release of Opus 5 on July 24. According to the announcement, Sonnet 5.5 and Haiku 5.5, which are the next tiers in the lineup, will be released "in the coming weeks," with similar performance improvements.

Opus 5.5 is Anthropic's first model release since CEO Dario Amodei embraced calls to pace the frontier, deliberately slowing down progress on AI capabilities to match the rate of progress on alignment. "I have become convinced that fully addressing the risks requires even more prudence," Amodei wrote in a post earlier this month, "not just investing in risk prevention, but pacing the rate of capabilities advancement so that risk prevention has time to keep up."

Anthropic says that Opus 5.5 is comparable to Mythos in its biology and cybersecurity capabilities, so its release is subject to the same safeguards as the company's Fable model. Those safeguards limit how much the models can be used to discover exploits in compiled programs or developing recognizable biological weapons, among other tasks.

Opus 5.5's safety training was broadly similar to its predecessors, with alignment testing and pre-release evaluation by outside organizations like METR and Frontier Design. But Anthropic emphasized that more advanced training and evaluation systems were already being prepared for future models, including improved security and monitoring systems.

"As AI becomes more capable, public policy should play a larger role in making sure the systems people rely on are safe. That capacity takes time to build, and we've started to put the infrastructure in place to support it," the blog post reads. "We expect to share more details on these efforts soon."

参考来源: TechCrunch
扎克伯格谈Muse 配图

扎克伯格谈Muse

核心内容
文章报道了扎克伯格接受科技记者Alex Heath专访的核心观点,围绕Meta新推出的个人AI Agent产品Muse展开:该产品上线不到两周即登顶美国下载榜首(累计下载超250万次),并详细阐述了其产品设计理念——从预训练阶段就植入个人目标理解与隐私边界判断能力,配合云端虚拟机、记忆系统和最小权限授权机制,让Agent能真正替用户持续行动。访谈同时涉及Meta在Llama 4失利后的模型研发重建(精简研究团队、吉瓦级算力集群、新模型"Watermelon"即将发布),以及扎克伯格"让更多人免费拥有强大AI"的战略主张。
为什么重要
这是Meta在Llama 4受挫后首次系统展示其AI战略转向:从开源模型竞争转向以产品为核心的个人Agent生态,标志着AI大模型竞争进入"产品落地+隐私架构"的新阶段。扎克伯格提出的"隐私保护写进系统架构"理念(连Meta自身也无法读取用户内容),可能重新定义用户对AI产品的信任标准,并给整个行业设立隐私设计的新范式。
关键洞察
最具价值的观点是:个人Agent的能力不能靠给通用模型"套壳"产品界面来实现,理解长期目标和信息使用边界必须从预训练开始设计——这等于宣布后训练微调路线在个人Agent领域存在结构性局限。此外,每周1亿token+一台虚拟机的免费额度策略,配合"从用户与商家交易中抽成"的商业模式,显示出Meta以规模换生态、以生态换变现的清晰路径。
潜在影响
个人AI Agent领域的竞争对手(如OpenAI、Anthropic、谷歌)将面临来自Meta免费策略和社交分发渠道的双重压力,可能被迫跟进免费模式;用户将逐步把邮件、账户管理等私人事务委托给AI,推动"最小权限原则"和机密虚拟机成为行业标配;同时Meta的算力扩张(吉瓦级集群)和即将发布的"Watermelon"模型,可能重新洗牌开源模型格局。

Muse上线后,Meta久违地拥有了一款迅速出圈的AI产品。不到两周,它便登上美国应用下载榜首。据Sensor Tower统计,截至9月22日,累计下载量已超过250万次。

为了让Agent真正替人行动,Meta给它配置了云端虚拟机;为了让用户敢把邮件、账户和私人信息交给它,又必须设计记忆、凭据存储和逐项授权的权限系统。扎克伯格认为,这些能力不能靠给现成模型增加一个产品界面完成;模型从预训练开始,就要学会理解个人目标,判断哪些信息可以使用、哪些不能向外披露。

展开全文收起全文剩余 23 段 · 约 6 分钟

这也是Muse背后更深的一场竞争。Meta首席执行官扎克伯格在与科技记者Alex Heath的对话中谈到了这套产品设计,也谈及Llama 4失利后Meta如何重建模型研发,以及他为什么主张让更多人拥有强大的AI。访谈主要观点包括:

**1. 个人Agent要从预训练开始设计。** 理解用户的长期目标,以及判断私人信息的使用边界,不能只靠通用模型的后训练来解决。

**2. 虚拟机让Agent具备持续行动的能力。** Muse可以在后台操作计算机、登录服务,并围绕用户的目标全天候推进任务。

**3. 记忆让Agent从单次工具变成长期服务。** 它会根据已完成的任务和用户反馈调整后续行动,夜间整理反思写入记忆,也可以主动提出新的项目。

**4. 权限决定用户敢把多少事交给AI。** 登录、付款、发送邮件和披露敏感信息需要用户逐项批准,Agent只能获得完成当前任务所需的权限,遵循最小权限原则。

**5. 隐私保护要写进系统架构。** Meta计划通过机密虚拟机和独立的凭据存储,减少公司及核心Agent接触用户敏感信息的机会,从架构上保证即使Meta自身也无法读取用户内容。

**6. 免费额度是扩大用户规模的起点。** Meta每周提供1亿token和一台虚拟机的免费额度,扎克伯格相信Muse帮用户省钱、赚钱后能抵消成本;长期可能从用户与商家交易中收取小额费用,目标是让多数人免费使用。

**7. Meta正用新的方式追赶前沿模型。** 在Llama 4偏离预期后,扎克伯格转向更精简的核心研究团队,并继续增加算力投入,俄亥俄州吉瓦级集群已上线;新模型"Watermelon"即将发布,规模更大、预训练水平显著提升。

**8. 技术扩散也是扎克伯格的安全主张。** 强大AI若只由少数机构掌握,同样会带来风险;让更多人获得能力,才能形成制衡。

## AI的安全不能只靠限制访问,关键是让更多人拥有制衡能力

Alex Heath:我们上次通话是在一个周末,你当时还通过智能眼镜给我打电话。那次你想谈刚发表的一篇长文,其中提出了很多关于AI未来的主张。为什么要写这样一篇近似宣言的文章?

Mark Zuckerberg:如果一家机构要在AI上投入这么多,就有责任说明自己的研究团队相信什么,以及这些工作为什么能够导向一个积极的未来。AI既带来巨大机会,也存在真实风险,所有参与者都应该形成一套经过认真思考的理论。

我强烈反对一些在行业内被视为理所当然的观点。在我看来,更积极的未来来自尽可能广泛地分发技术。这一判断建立在三点之上:第一,赋予个人更多能力,一直是人类繁荣的重要来源;第二,AI的首要用途将是创造新事物,而不是将现有工作自动化;第三,未来安全的基础应是适当的权力制衡,而不是限制使用权。

很多人的直觉是,技术越强,就越应该只让少数人接触。我更担心的是,只有少数研究机构或个人控制如此强大的能力。历史上,很多重要进步并非来自既有权力中心,而是来自边缘位置、最初不被认真对待的人。当他们获得足够好的工具,可以证明自己的想法时,才有机会推动真正的变化。

网络安全也是如此。如果有人拥有能够攻击系统的AI,最有效的应对方式之一,是让更多机构也拥有AI,以便提前加固自己的系统。开源软件之所以常常更安全,正是因为更多人能够查看、检验和修正它。把技术交到更多人手里,看似会增加风险,却也可能形成更稳定的制衡。

Meta会开发领先模型,也会发布一部分开放模型,但这不意味着所有成果都必须开源。营利性公司可以保留一部分先进技术。关键是维持强健的开源生态,让市场保持竞争,也让外界能够理解技术的发展方向。以Hugging Face遭遇入侵的事件为例,他们发现入侵后转而使用开源模型,因为他们无法获得某些与这次问题有关的闭源模型。这说明世界上需要保护的重要机构远不止排名最靠前的一百家。

不过,比开源本身更重要的,是让普通人真正用上技术。Muse体现的就是这一思路:给每个人一个能力很强的个人AI Agent,让它理解用户的目标,并且每天24小时持续代表用户工作。

## 技术繁荣必须广泛分布,数据中心也要让社区受益

Alex Heath:AI和数据中心正在受到越来越强烈的抵触。你的意思是不是,如果更多人能够得到目前集中在少数研究机构手中的能力,他们就不会再觉得自己被排除在AI进程之外?

Mark Zuckerberg:问题不能只停留在抽象层面。人们担心就业和经济,也担心数据中心对社区与环境的影响;还有网络攻击、生物安全、自由社会、美国的技术领导力,以及当AI越来越强时,人类如何继续控制它。每一类问题都有不同细节,但它们有一个共同点:技术带来的繁荣必须广泛分布,能力也不能只掌握在少数内部参与者手中。

Meta进入一个地区建设数据中心,实际上是在承诺未来几十年持续投资。这样的长期投入可以为社区带来税收、就业和其他资源。比如在路易斯安那州,相关税收曾为当地教师提供每人5万美元的奖金。市场上也有另一类项目:有些公司只想先拿下一块地,再卖给大型AI研究机构。

它们并不打算长期运营,也没有动力认真处理与当地社区的关系。我不确定是否该把这种现象称为泡沫,因为"泡沫"意味着估值过高。但这个领域确实正在经历一轮热潮,也因此容易滋生短期逐利的行为。如果项目只顾眼前交易,社区反对并不奇怪。AI基础设施如果不能创造就业、扩大社会整体繁荣,也不能让当地社区受益,就不可能无限扩张。因此,让利益广泛分布不是附加条件,而是行业能够持续发展的前提。技术要可行,社会层面也必须可行。

Meta推出了America's Workforce Academy,原因很实际:建设数据中心需要大量光纤技术人员、电工、高级木工等技术工人,而市场上远远不够。未来可能还需要数十万甚至数百万人。我们保证,完成培训的人能够在参与Meta基础设施建设的单位找到工作。这不是单纯的慈善,而是长期利益一致:Meta需要熟练工人,参与者需要新的职业机会。若企业只是建设一个项目后转手,就不会进行这种投入。

参考来源: 虎嗅
✨ AI 助手